
StarHarness:用分层搜索为企业环境演化 Harness
原文:StarHarness: Evolving Harnesses with Stratified Search for Enterprise Environments 作者:Esakkivel Esakkiraja, Denis Akhiyarov, Vikas Yadav, Sai Rajeswar, Patrice Bechard, Sridhar Nemala, Sagar Davasam(ServiceNow;Mila;蒙特利尔大学) arXiv:2608.24804,提交于 2026-08-25 | 代码:github.com/ServiceNow/StarHarness
摘要
我们提出 StarHarness,一个在保持模型权重固定的前提下、演化环境特定智能体 harness 的框架。被演化的 harness 可以包括提示词与任务框定、工具接口、skills、MCP 支撑的 provider、subagent 结构,以及 agent-loop 配置。StarHarness 按基线失败行为对任务分层,构建一个紧凑的演化池;把 proposer 可见的搜索任务与 proposer 不可见的选择任务分离;并保留留出(held-out)任务用于评估泛化。在 ITBench SRE、EnterpriseOps-Gym ITSM 和 AutomationBench Finance 三个基准上,harness 演化在每个环境仅接受 4–12 个变更之后,将全基准性能相对默认 harness 提升 20–35 个百分点。这些增益在被排除于演化之外的任务上持续存在,并且无需重新演化即可跨 GPT 与 Qwen 模型家族迁移。轨迹分析将这些改进归因于接口修复、环境惯例、以及压缩搜索的运营知识,并在若干设置中观察到更少的假阳性诊断和更短的轨迹。因此,StarHarness 为减少工具密集型企业任务中持续存在的模型–环境失配提供了一条实用路径。
1 引言
现代 LLM 智能体通过 harness 行动,harness 定义了它们如何使用工具、如何解释状态。工具增强型智能体依赖推理、动作与外部状态之间的交互(Yao et al., 2023; Schick et al., 2023)。在工具密集的企业任务中,harness 设计决定了智能体能否检索到正确的记录、执行有效的变更操作、并满足精确的最终状态检查(Rombaut, 2026; Meng et al., 2026)。接口设计可以在不改变模型权重的情况下改变智能体行为与任务成功率(Yang et al., 2024)。
企业服务管理与工作流智能体必须通过有状态的后端、庞大的工具面、跨步骤依赖、以及工具 schema 常常遗漏的领域惯例来行动。我们的基准捕捉了这个更广泛问题的不同实例:ITBench 测试基于运维遥测数据的根因分析(Jha et al., 2025);EnterpriseOps-Gym 用数据库断言测试改变状态的 ITSM 工作流(Malay et al., 2026);AutomationBench 用程序化状态检查测试多应用财务工作流(Shepard & Salimans, 2026)。它们共同暴露了让企业工具使用变得困难的状态依赖、策略约束和最终状态要求(Yao et al., 2024; Lu et al., 2024),并提出三个问题:搜索能否从一个紧凑的任务子集演化出 harness 而不对该子集过拟合?由此产生的变更能否迁移到未见过的任务和其他模型?harness 演化到底修复了哪些交互失败?
StarHarness 通过在保持模型权重固定的前提下演化环境特定的 harness 来回答这些问题。该方法按基线失败行为对任务分层,把 proposer 可见的搜索任务与 proposer 不可见的选择任务分离,并保留留出任务用于评估。
我们的贡献:
- 高效的分层 harness 演化。 我们提出一个 harness 演化协议:在按失败模式分层的紧凑任务子集上搜索,同时分离 proposer 可见的搜索任务、proposer 不可见的选择任务与留出评估任务。这提供了对泛化的直接度量。
- 专用 harness 的任务与模型迁移。 在三个有状态企业基准上,用一个模型演化出的 harness 能改进被排除于演化之外的任务,并且无需重新演化即可跨 GPT 与 Qwen 模型迁移。
- 对习得专门化的分析。 我们识别出三种反复出现的环境专门化形式:接口修复、环境惯例、以及压缩搜索的运营知识,并把它们与智能体的精确度、收敛性和效率的变化联系起来。
2 相关工作
2.1 提示词与 Harness 优化
提示词优化方法用生成的候选、文本反馈或演化式选择来搜索指令与示例(Opsahl-Ong et al., 2024; Agrawal et al., 2025)。智能体架构方法把搜索扩展到可执行模块与工作流结构(Khattab et al., 2024; Zhang et al., 2025)。
近期的 harness 级系统直接编辑可执行的脚手架,或将 harness 与模型策略、权重共同演化(Lee et al., 2026; Hebbar et al., 2026)。
StarHarness 研究一个更窄的部署问题:把一个冻结模型的 harness 适配到一个有状态的企业环境。其搜索空间包括提示词、工具、skills、MCP provider、subagent 与执行策略。这一文献中的评估协议各不相同:Meta-Harness 在文本分类和数学推理上使用留出集,但在同一个 89 任务的 TerminalBench-2 基准上搜索并报告最终性能,其作者将此框定为"发现"(discovery)设定(Lee et al., 2026)。我们使用任务级分离、proposer 不可见的选择集与留出评估来区分搜索性能与泛化,呼应了近期对更严格 harness 演化评估的呼吁(Wang et al., 2026)。所产生的编辑始终位于模型权重之外,可以像普通代码变更一样被测试和回滚。
2.2 智能体基准与企业环境
现有基准以不同的交互接口覆盖了相关的智能体场景。WorkArena(Drouin et al., 2024)研究 ServiceNow 平台上基于浏览器的知识工作,Terminal-Bench 2.0(Merrill et al., 2026)在隔离环境中评估困难的命令行任务。我们聚焦三个互补的企业场景:ITBench(Jha et al., 2025)包含 40 个 Kubernetes 根因分析场景,智能体在给出结构化诊断之前需要检查告警、事件、trace、指标与拓扑;EnterpriseOps-Gym(Malay et al., 2026)包含 103 个 ITSM 工作流,横跨事件、问题、变更、知识与用户管理任务,用 SQL 验证器检查最终的 ServiceNow 状态;AutomationBench(Shepard & Salimans, 2026)包含 100 个财务工作流,横跨 47 个模拟 SaaS 应用,用针对环境状态的程序化断言打分。这些基准要求智能体操作领域工具、维护持久状态、满足工作流特定目标。我们用它们来度量一个冻结的专用 harness 的任务级泛化与跨模型迁移。
3 方法
3.1 概览
我们把 harness 演化定义为对围绕固定语言模型的可执行脚手架的外环(outer-loop)优化。在我们的实现中,StarHarness 优化器是一个基于 Oh My Pi(contributors, 2026)——Pi agent harness(Zechner, 2026)的一个变体——构建的编码 harness。它承载 proposer 并执行"编辑、验证、评估"循环:暴露被允许的仓库与基准轨迹,应用候选补丁,运行检查,并发起基准评估。优化器修改的是另一个独立的 Stirrup harness(Artificial Analysis, 2026),后者是被评估的智能体 harness。其可编辑面包括提示词与任务框定、工具定义与 schema、参数预处理、skills、MCP provider、subagent 结构、上下文管理、验证与结束逻辑。演化期间模型权重与基准保持固定。
设 D 表示一个基准,h 表示一个 harness,M 表示智能体模型,J(h; D) 为代价函数,此处定义为用 h 驱动 M 在 D 上运行得到的平均任务分数,越高越好。优化目标是
h* = argmax_{h ∈ H} J(h; D_holdout) (1)
其中 H 是被允许的 harness 空间。StarHarness 在搜索期间无法访问留出集的结果,因此它用 proposer 可见的搜索任务和(适用时)proposer 不可见的选择任务来近似这一目标,把 D_holdout 保留给最终评估。
编码 harness 运行三个阶段:提议、验证、评估。proposer 读取当前 harness 与搜索集轨迹并返回一个候选补丁。验证器检查作用域、import 与单任务冒烟测试。当存在选择集时,评估器在不可见的选择集上运行有效候选;演化循环应用固定的接受规则。遵循 autoresearch 模式(Karpathy, 2026),演化循环先测量基线,提出一个有界干预,评估它,只保留改进,然后从新的前沿(frontier)重复。一个持久的记忆台账(memory ledger)把补丁、会话与评估工件关联起来,并把前沿分数、逐任务结果、被接受的假设和被丢弃的尝试带入后续迭代。对树搜索而言,台账是一个解日志(solution journal),包含候选节点、父链接、分数、失败状态与晋升决策。图 1 以算法形式给出该过程。
演化循环首先运行一个由 proposer 选定的单任务翻转测试(test flip)。如果候选没能翻转该任务,循环记录一次拒绝并跳过昂贵的评估。通过该门槛的候选在选择集上评估;晋升保持确定性:候选必须改进选择集均值,只有当验证器通过率这一额外指标可用时才用它做平手判定。循环把被接受的候选提交为新前沿并刷新搜索轨迹;被拒绝、无效或崩溃的候选回滚到之前的前沿。
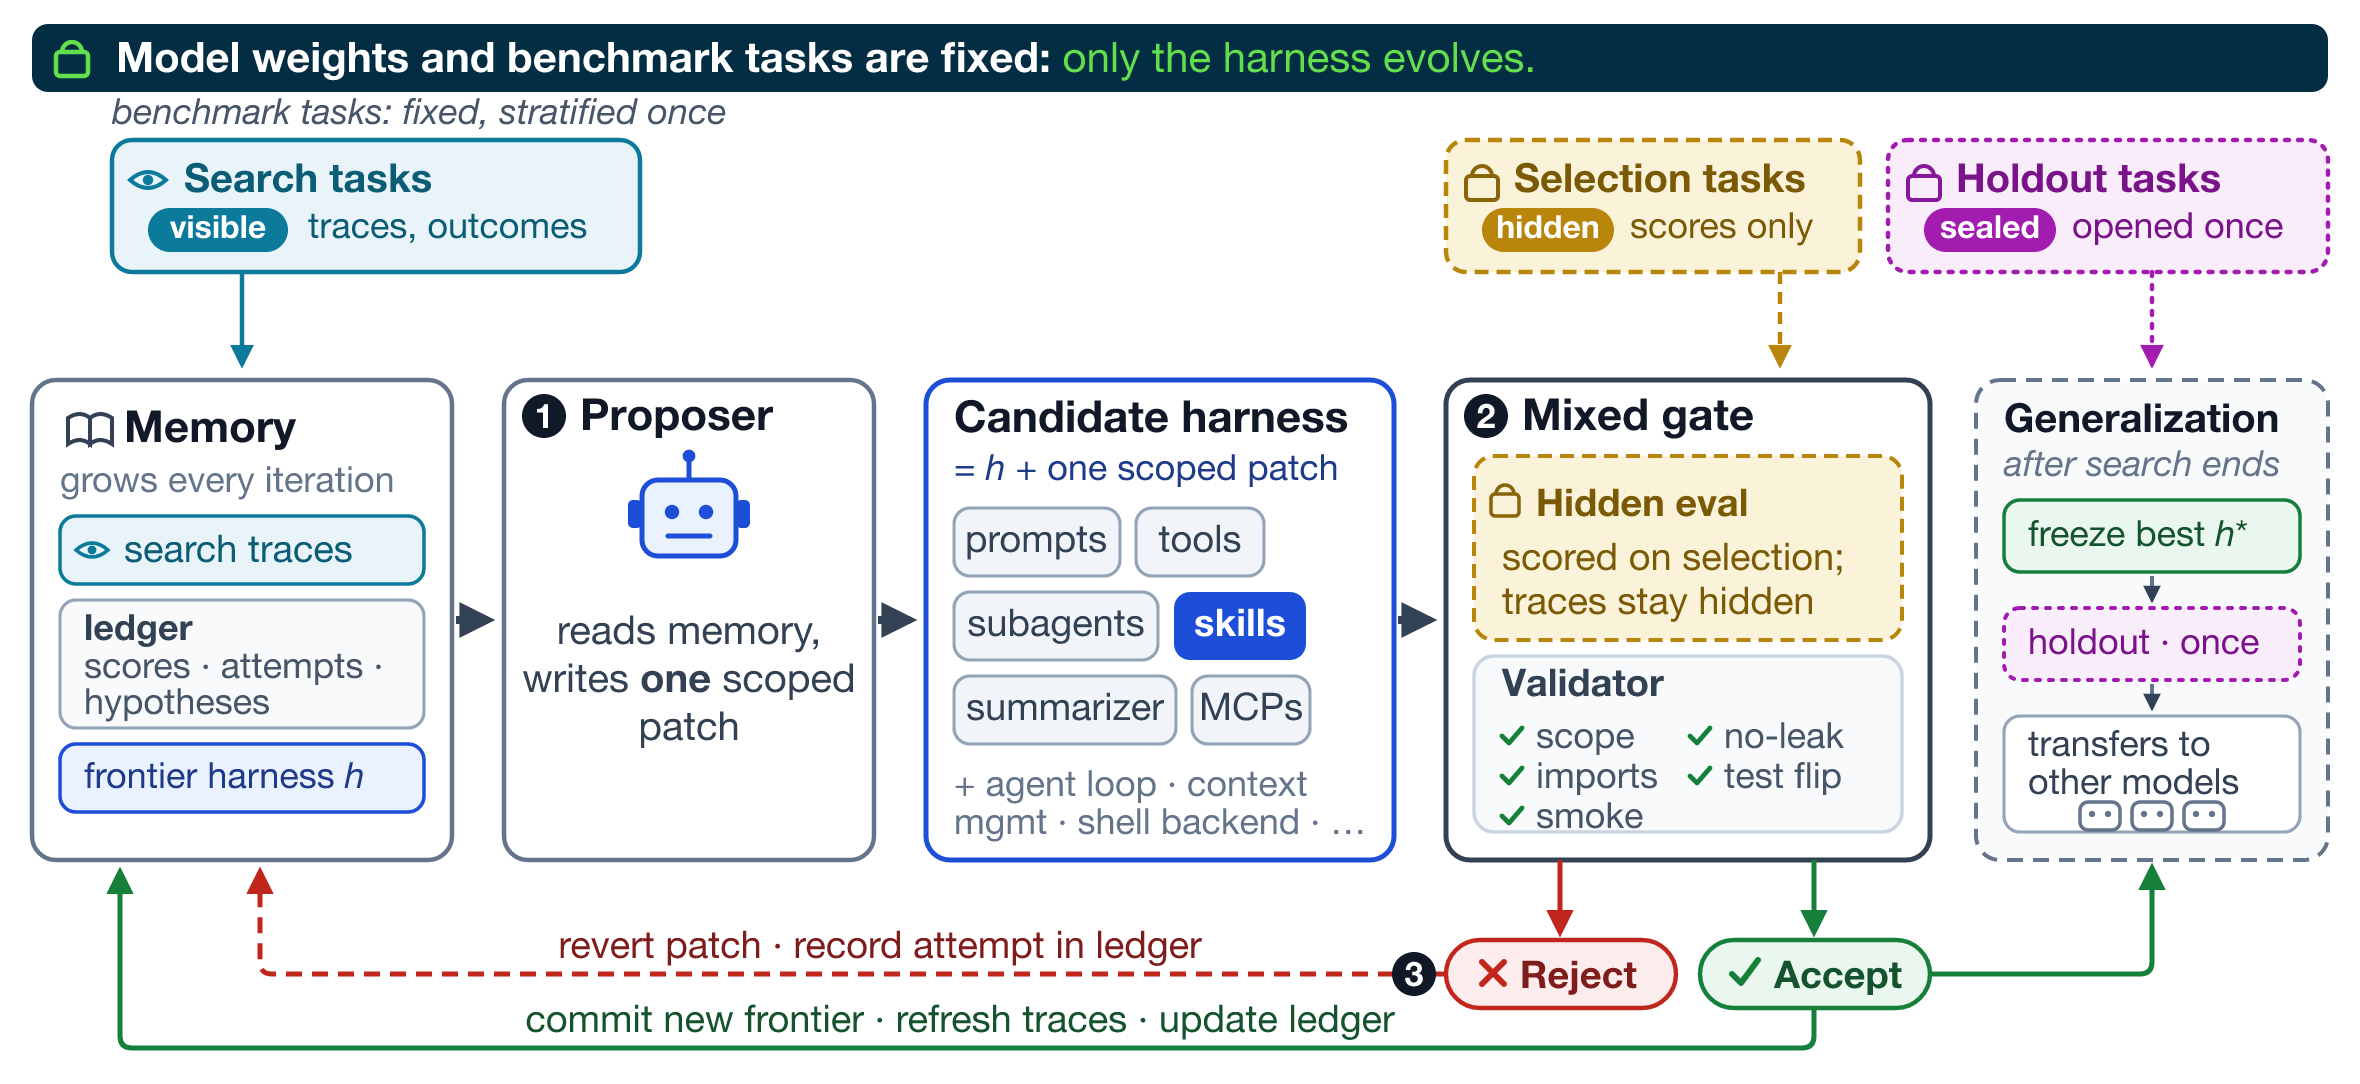
算法 1:StarHarness 演化 输入:基准 D;固定模型 M;种子 harness h₀;proposer P;预算 B。输出:演化后的 harness h*。
- 在 D 上运行 h₀;记录分数与失败分层
- 构建 D_search、D_select、D_holdout
- h ← h₀;s ← J(h; D_select);初始化台账 L
- for t = 1, …, B:
- L ← 加载台账;T ← 收集搜索轨迹
- Δ ← P(h, T, L);把 Δ 捕获为限定作用域的补丁
- 若作用域、泄漏、import 或冒烟检查失败:回滚并记录拒绝
- 否则运行 proposer 选定的翻转测试
- 若翻转测试失败:回滚并记录拒绝
- 否则在不可见的 D_select 上评估 h ⊕ Δ
- 若选择集分数改进,或持平且可用的验证器指标改进:提交 h ⊕ Δ;更新 L;刷新 T
- 否则:回滚 Δ;更新 L
- 返回 h;在 D_holdout 与 D 上各评估一次
图 1:StarHarness 演化。上:对应的工作流;下:可执行过程。proposer 读取当前前沿、持久记忆台账与搜索集轨迹,但永远看不到选择集或留出集轨迹。候选先通过限定作用域的验证与 proposer 选定的翻转测试,再进入不可见的选择集评估;被接受的编辑推进已提交的前沿并刷新台账与搜索轨迹。对树搜索而言,台账存储候选节点与父链接,而不只是单一贪心前沿。
3.2 任务划分与分层抽样
我们在演化开始前构建任务划分。从共 N 个任务的完整基准中,先保留 N′ 个评估可复现的任务,然后用三个基线描述量抽样出一个 K 个任务的演化池(通常 K ≈ N/2):
- 基线失败模式(如 wrong_tool、context_loss、missing_evidence、premature_conclusion)
- 基线任务分数
- 验证器通过率
这些描述量来自演化前在全部 N′ 个任务上的一次基线运行。当协议使用选择集时,我们把演化池拆分为 proposer 可见的搜索任务与 proposer 不可见的选择任务,并匹配二者的基线分数、失败模式与验证器通过率分布。proposer 收到搜索任务的轨迹与结果,但收不到选择任务的内容、轨迹、验证器反馈或逐任务结果。其余 N′−K 个任务构成留出集,永远不影响提议或接受。
3.3 搜索策略:探索与利用
我们在两种搜索过程中使用相同的 proposer、验证器、评估器与接受分数。在爬山法(hill climbing)中,状态是单一的前沿 harness。在第 t 次迭代,proposer 从当前前沿的轨迹中产出一个补丁 Δₜ;系统当且仅当 hₜ ⊕ Δₜ 严格改进选择集分数、或持平且改进可用的验证器指标时保留它,否则恢复 hₜ。
在树搜索中,状态是一组候选节点。每个节点存储父指针、累积补丁、搜索轨迹、验证状态与选择集分数。proposer 可以探索一个失败模式、起草一个补丁、调试一个失败的候选、合并两个兼容节点、或改进一个已有节点。有效节点在同一个不可见选择集上打分;最佳存活节点成为后续精化的前沿。这保留了备选假设,而不是在第一个被接受的编辑后就锁定。
我们仅在 EnterpriseOps-Gym 上把这两种模式用作一个探索–利用对照实验。树搜索探索备选假设;爬山法随后通过有界的局部编辑利用最佳的树前沿。两个阶段是先后进行的,因此这个设计描述的是两种模式如何互补,而不提供因果性的正面对比。
3.4 护栏与候选隔离
StarHarness 执行的是基准辅助的环境适配:proposer 可以检查搜索任务的轨迹及其评估结果以诊断反复出现的失败,但护栏防止它编码任务特定的答案。
每个候选是相对当前前沿的一个 git diff,作用域限定在基准的可编辑目录与共享智能体框架内。被禁止的变更包括:
- 按任务 ID 分支或硬编码答案
- 在智能体提示词中放入验证器或断言内容
- 真值表或对隐藏状态的访问
- 基准特定的答案映射
这些约束瞄准的是可复用的环境行为,而非单个任务的解。验证器在基准评估前检查作用域、import 与单任务冒烟测试。演化循环对未通过任何检查的候选直接回滚,不运行选择集评估。
4 实验
4.1 实验设置
基准。 我们在三个企业基准上评估:
- ITBench SRE(Jha et al., 2025):ITBench-AA SRE 集的最新公开版本,包含来自 OpenTelemetry demo 应用的 40 个 Kubernetes 根因分析场景(数据集:huggingface.co/datasets/ArtificialAnalysis/ITBench-AA)。智能体检查一个包含告警、事件、trace、指标与拓扑的离线事故快照,然后写出识别相关实体的结构化诊断。我们的 Stirrup 基线在可用之处遵循文档化设置,包括沙箱代码执行环境、基于 shell 的快照检查与结构化 JSON 输出。
- EnterpriseOps-Gym ITSM(Malay et al., 2026):103 个 ITSM oracle 任务(事件、问题、变更、知识与用户管理),是更大的 1,150 任务基准的一个子集,针对 ServiceNow MCP 后端运行,由检查最终数据库状态的 SQL 验证器打分。
- AutomationBench Finance(Shepard & Salimans, 2026):100 个财务工作流任务(应付/应收、费用、报表、记账),横跨 47 个模拟 SaaS 应用,由针对环境状态的程序化断言打分。我们报告模型达成的领域目标份额;护栏违规使该任务得 0 分。我们的 Finance-100 子集与 Stirrup harness 不同于基准论文的默认设置,因此分数与 Shepard & Salimans (2026) 报告的分数不可直接比较。
三个基准均按 Artificial Analysis 的评估描述(artificialanalysis.ai/evaluations)打分。对 AutomationBench,该分数由模型达成的领域目标份额计算,护栏违规使任务得 0 分。
模型。 我们用 GPT-5.4(medium 推理)作为受测智能体模型演化 harness,proposer 同为 GPT-5.4,运行在基于 Pi 的编码 harness 内(OpenAI, 2026)。随后我们把同一个冻结的演化后 harness——不做重新演化——在每个基准上评估更多 GPT 与 Qwen 模型,包括 Qwen3.6(Qwen Team, 2026)。
基线。 各基准的基线是带默认提示词与工具配置的未修改 Stirrup 智能体框架。我们还与独立的 Pi、Codex harness,以及叠加在 Pi harness 之上的 GEPA 提示词优化对比。
4.2 主结果
图 2 汇总了全基准 harness 对比。分数采用各基准自身的指标,越高越好。StarHarness (Stirrup) 指演化后的 Stirrup harness,GEPA (Pi) 指叠加在 Pi harness 上的提示词优化。
StarHarness (Stirrup) 在全部三个基准上都是最强配置。相对 GEPA (Pi)(Agrawal et al., 2025),在 ITBench、EnterpriseOps-Gym 与 AutomationBench 上的增益分别为 +13.8、+22.3、+17.6 个百分点。这一对比是描述性的:这些系统在提示词、工具、执行策略与 harness 架构上都不同,因此无法隔离单一因果成分。该结果表明:环境特定的 harness 设计能在纯提示词优化之外增加可观的性能。
性能增益还伴随着更低的 GPT-5.4 单任务推理成本估计:按公布价格(OpenAI, 2026),StarHarness 在 ITBench 上降低成本 17%,在 EnterpriseOps-Gym 上降低 53%,在 AutomationBench 上降低 29%。
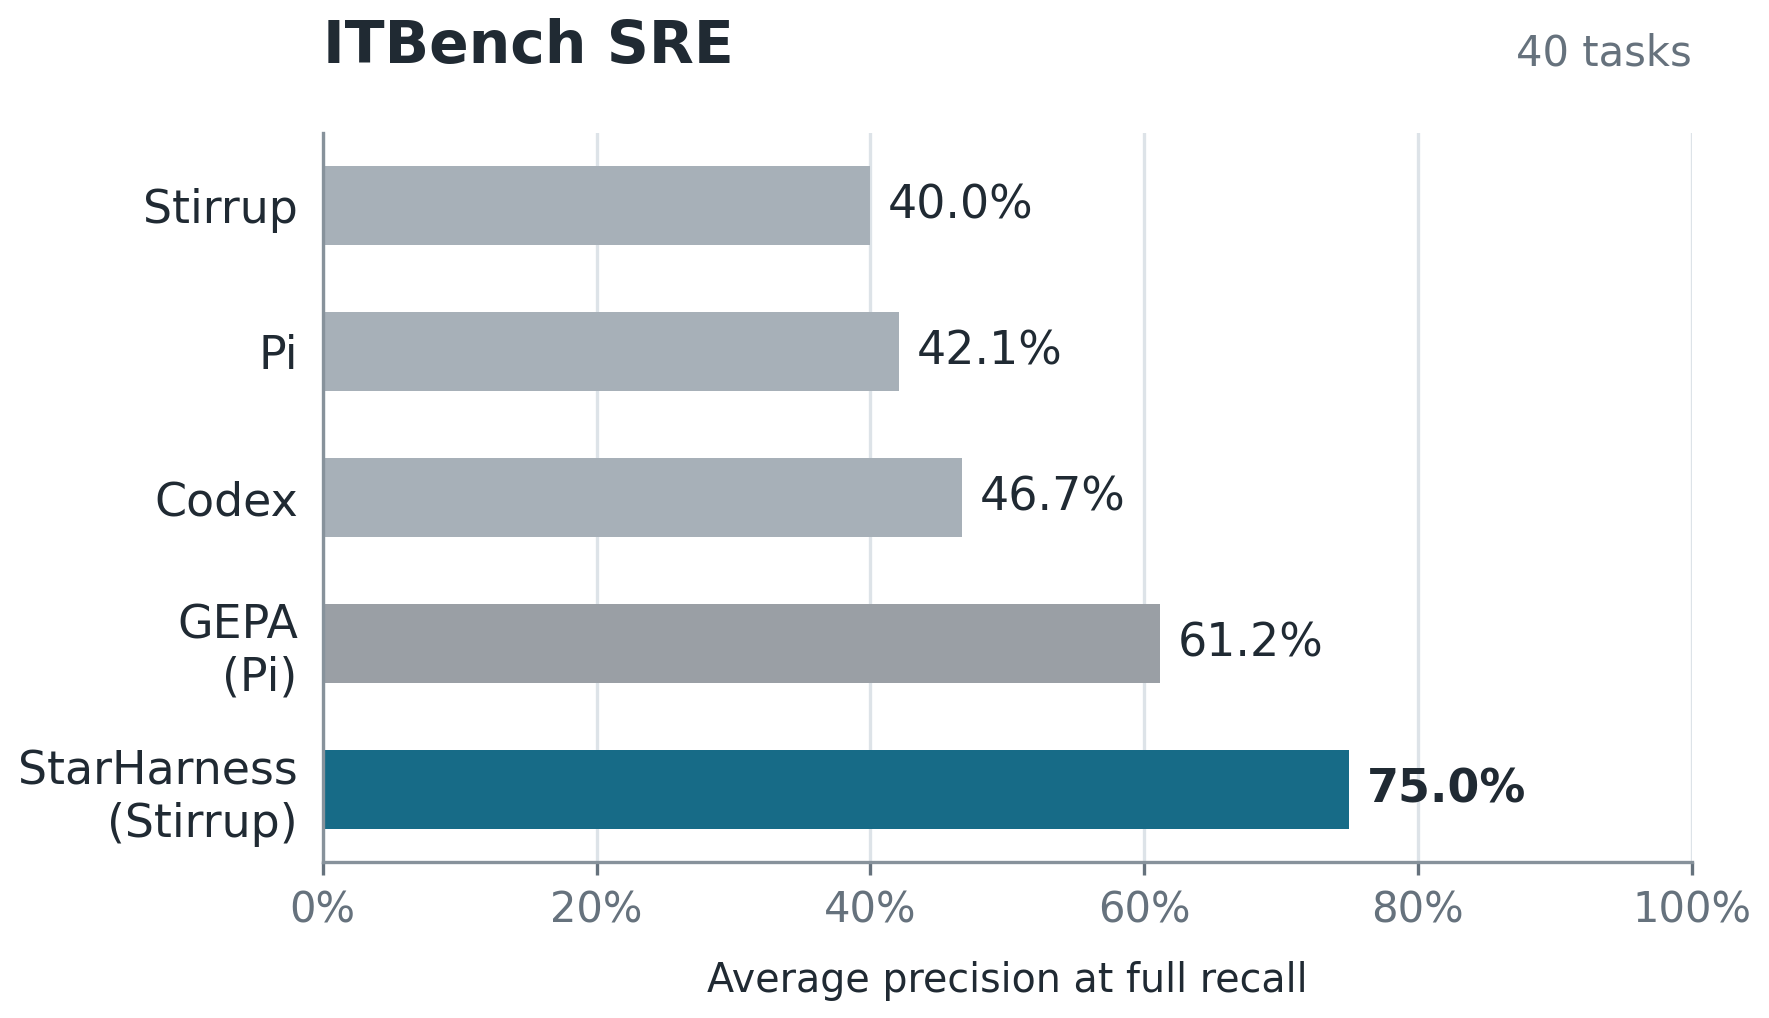
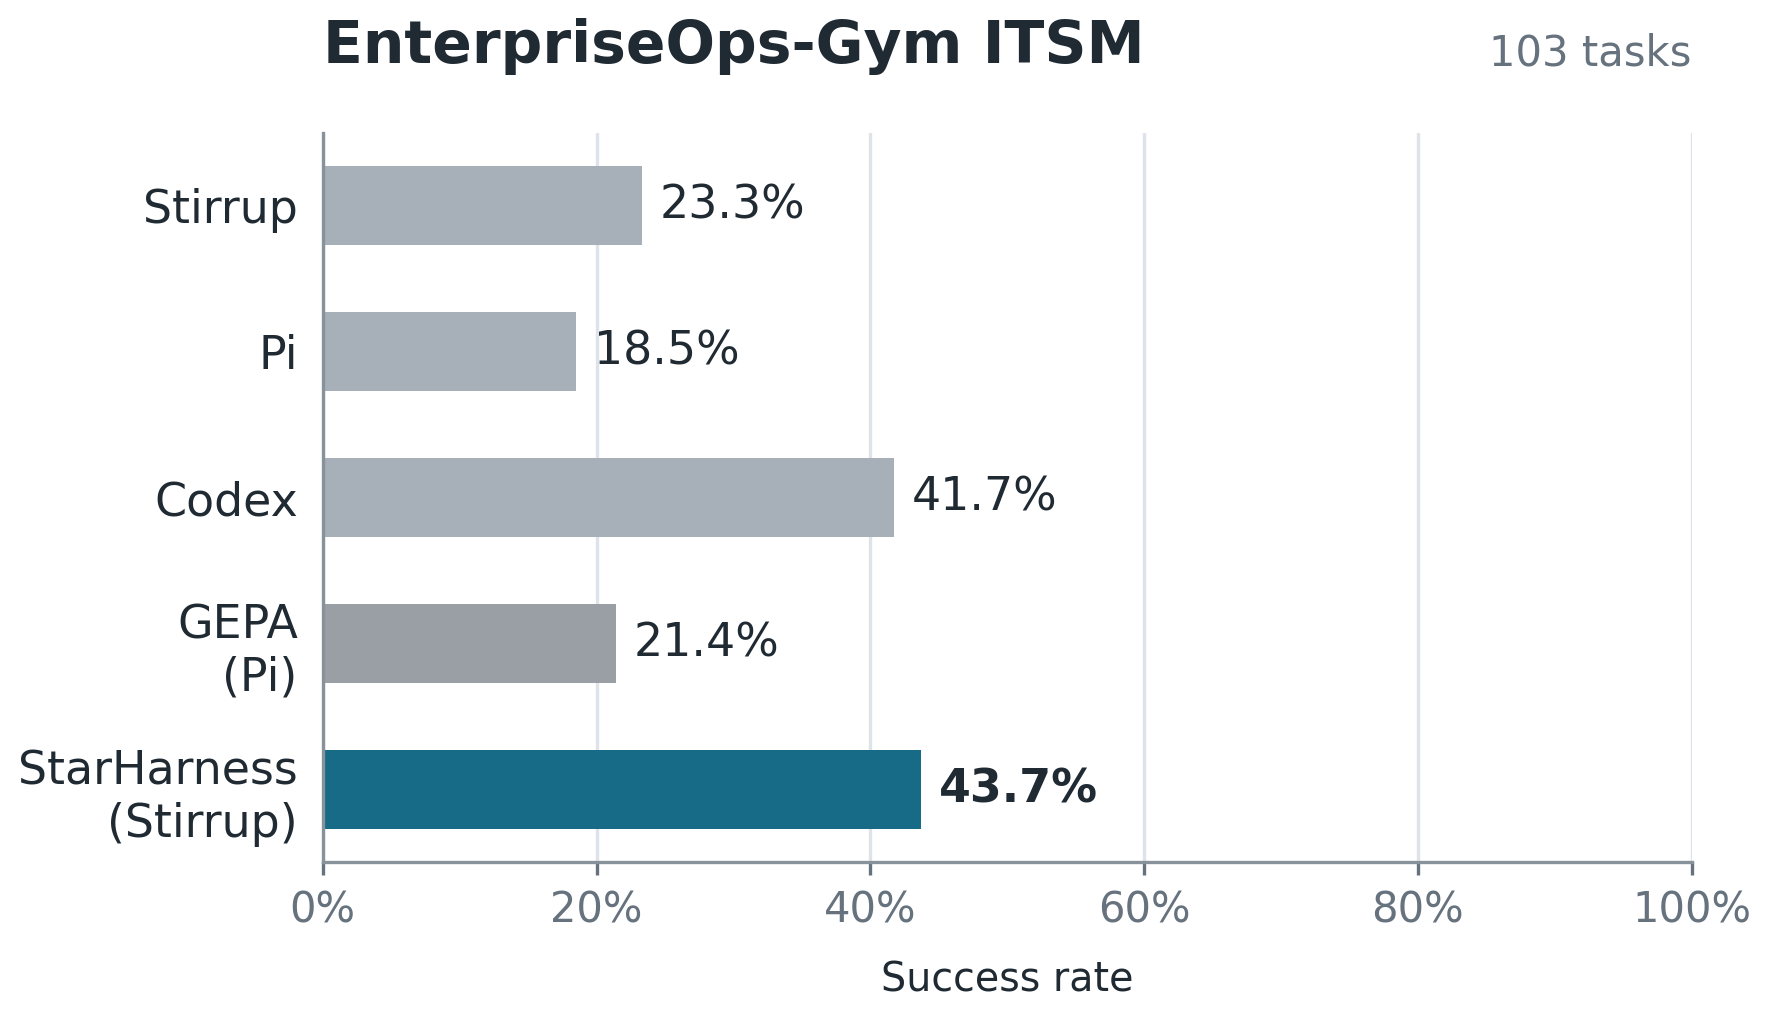
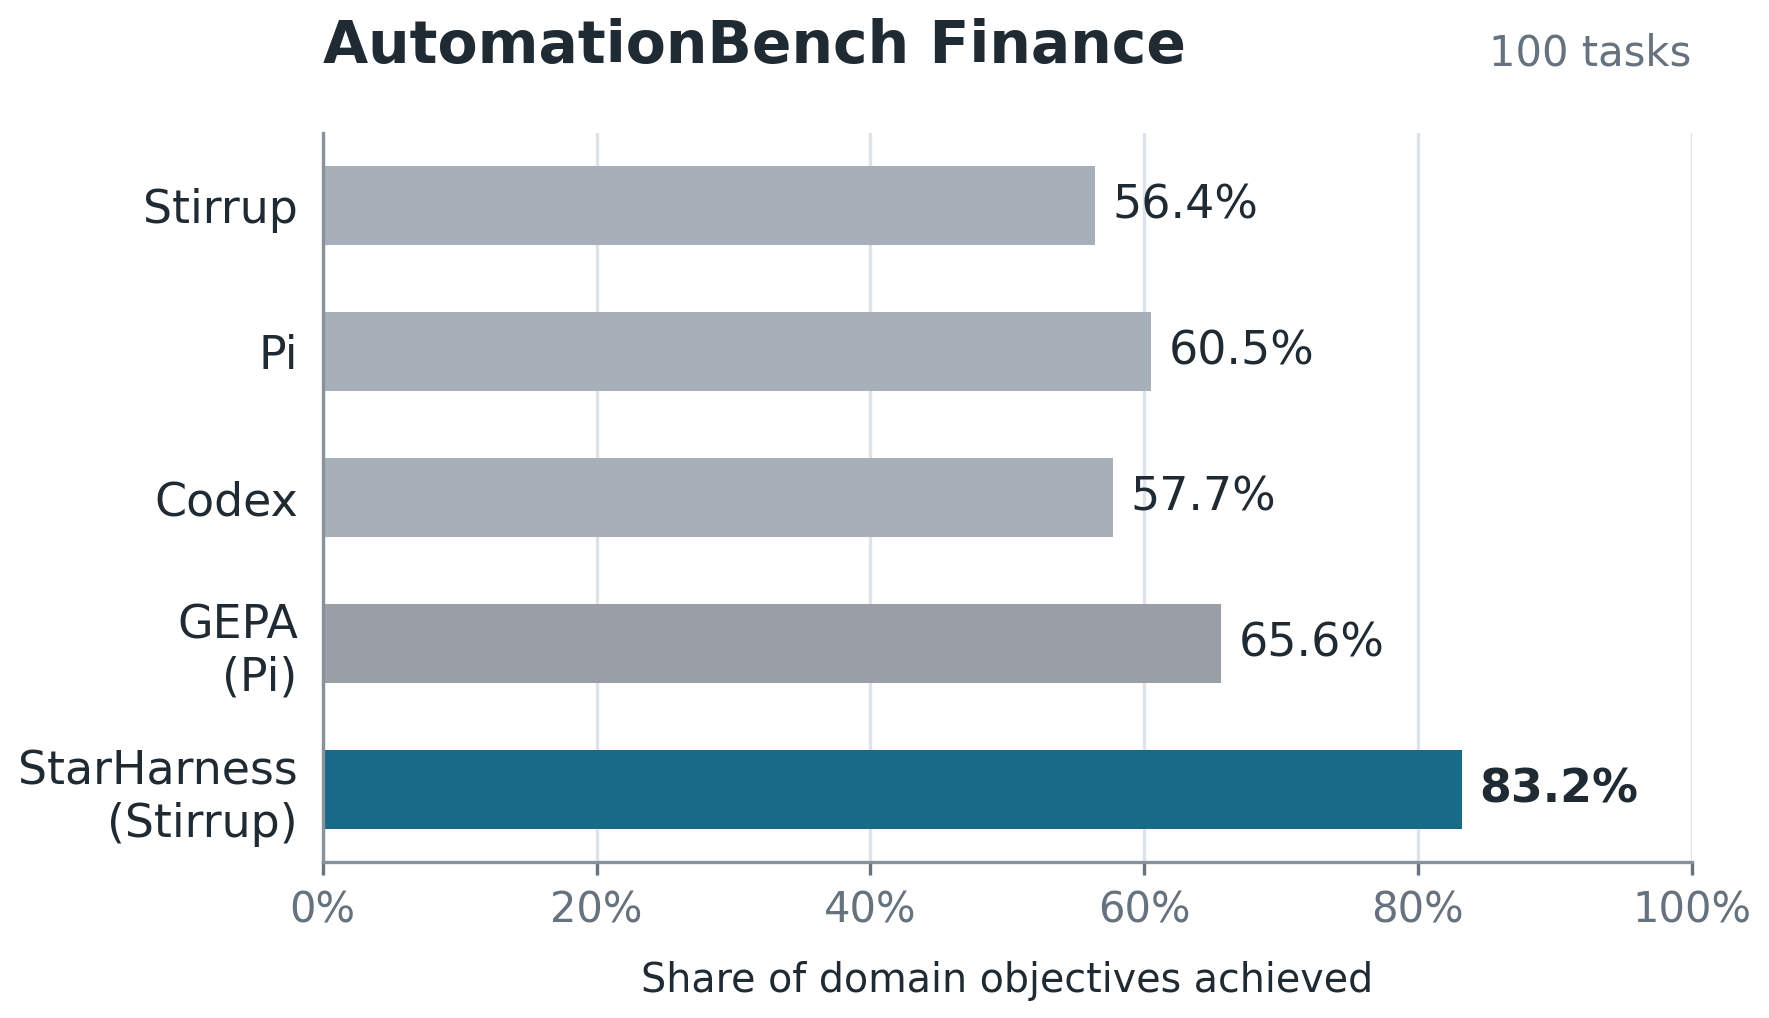
图 2:ITBench SRE、EnterpriseOps-Gym ITSM 与 AutomationBench Finance 的全基准 harness 对比。GEPA (Pi) 指叠加在 Pi harness 上的提示词优化;StarHarness (Stirrup) 指演化后的 Stirrup harness。AutomationBench 分数为模型达成的领域目标份额,护栏违规记 0 分。
4.3 冻结跨模型迁移
表 1 汇总了全部三个基准上的冻结 harness 迁移结果。每个演化后 harness 的分数用的都是同一个以 GPT-5.4 演化出的 StarHarness 工件;对被迁移的模型未做任何基准特定的重新演化。该 harness 改进了表中每一个被迁移的模型,包括 GPT 与 Qwen 两个家族。
表 1:冻结 StarHarness 的跨模型迁移。数值为全基准分数;括号内为推理档位(如适用)。
| 基准 | 模型 | 基线 | StarHarness | Δ |
|---|---|---|---|---|
| ITBench | Qwen3.5-27B | 25.6% | 70.0% | +44.4 pp |
| ITBench | GPT-5.4-mini (medium) | 33.1% | 79.4% | +46.3 pp |
| ITBench | GPT-5.4 (medium) | 40.0% | 75.0% | +35.0 pp |
| ITBench | GPT-5.5 (medium) | 50.8% | 78.7% | +27.9 pp |
| EnterpriseOps-Gym | Qwen3.6-27B | 18.2% | 38.8% | +20.6 pp |
| EnterpriseOps-Gym | GPT-5.4-mini (medium) | 13.6% | 31.1% | +17.5 pp |
| EnterpriseOps-Gym | GPT-5.4 (medium) | 23.3% | 43.7% | +20.4 pp |
| EnterpriseOps-Gym | GPT-5.5 (high) | 37.8% | 48.5% | +10.7 pp |
| AutomationBench | Qwen3.6-27B | 48.2% | 75.5% | +27.3 pp |
| AutomationBench | GPT-5.4-mini (medium) | 29.6% | 70.0% | +40.4 pp |
| AutomationBench | GPT-5.4 (medium) | 57.1% | 83.2% | +26.1 pp |
| AutomationBench | GPT-5.5 (medium) | 59.6% | 84.9% | +25.3 pp |
作为参照,EnterpriseOps-Gym 一轮还报告了外部 Claude 参考分数:48.1%(Fable 5)、35.9%(Sonnet 5)、35.5%(Opus 4.8 max),见图 3。这些参考运行不属于受控的"基线–StarHarness"对比。
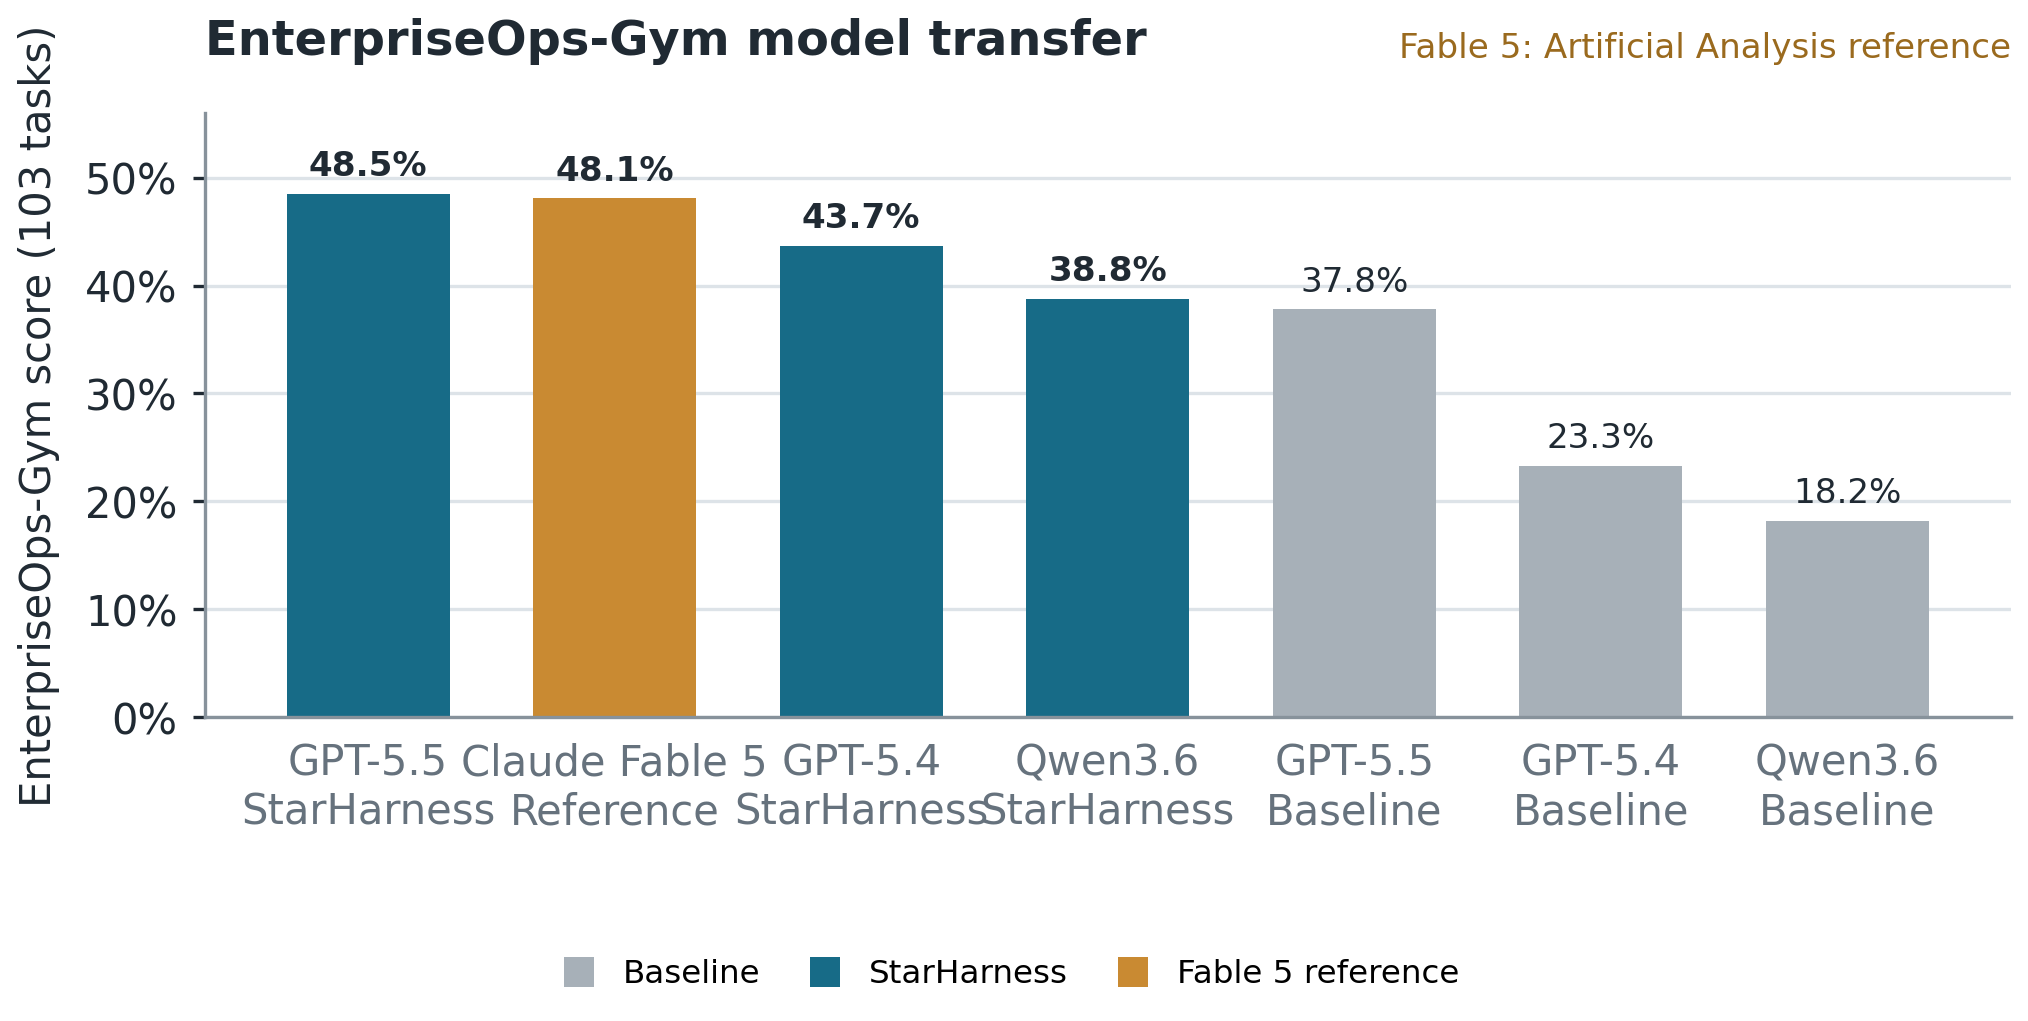
图 3:EnterpriseOps-Gym 模型迁移榜单。Claude Fable 5 分数是外部 Artificial Analysis 参考值,不属于受控的基线–StarHarness 对比。
4.4 留出泛化
表 2 汇总了 GPT-5.4 在三个基准上的泛化情况。
表 2:GPT-5.4 泛化汇总。数值为绝对增益(百分点)。
| 基准 | 模型 | 演化集 | 留出集 |
|---|---|---|---|
| ITBench | GPT-5.4 | +45.0 | +31.7 |
| EnterpriseOps-Gym | GPT-5.4 | +22.0 | +15.1 |
| AutomationBench | GPT-5.4 | +23.0 | +29.3 |
5 分析:Harness 演化学到了什么
三次演化运行共接受了 21 个补丁:ITBench 4 个、EnterpriseOps-Gym 12 个、AutomationBench 5 个。在 EnterpriseOps-Gym 上,8 个被接受的补丁来自树搜索探索阶段,4 个来自随后的爬山阶段。树阶段暴露了相互作用的 schema、提示词与工具失败;爬山阶段随后加入了针对性的关联与落地修复。跨基准来看,这些编辑处理了三类模型–环境摩擦。
接口修复。 EnterpriseOps-Gym 的演化修复了 MCP 参数处理,保留了复合 schema,剪除了误导性字段,并加入了关联与自引用提示。这些变更让既有环境接口更可用,而不改变任务数据或验证器。AutomationBench 类似地获得了结构化的行操作,替换了脆弱的原始电子表格编辑。
Codex 在 EnterpriseOps-Gym 上提供了一个贴近的参照:它得 41.7%,StarHarness 为 43.7%。Codex 默认的 MCP 预处理会归一化并压缩 schema,减少对严格的 Docker 后端服务器的无效调用——该服务器会拒绝违反 schema 的显式 null 与空值。StarHarness 学到了互补的修复:先收窄并丰富 schema,然后在调用抵达服务器之前剥除 null、空值与占位参数。
环境惯例。 演化后的 harness 把隐性的运营规则显式化。例子包括 EnterpriseOps-Gym 的执行契约、优先级与影响度/紧急度的联动更新、以及保留关系字段的要求。在 AutomationBench 中,系统指引把相对日期锚定到沙箱时钟,并在变更操作前加入分诊(triage)步骤。harness 编码了这些流程,而模型权重保持固定。
运营知识与搜索压缩。 若干补丁把可重复的工作移出了开放式推理。ITBench 获得了一个取证概览(forensics overview),从观察到的证据对候选上游原因排序。AutomationBench 获得了日期与财务计算器,用于确定性的时间与数值运算。这些变更编码了运营知识并压缩了搜索;它们暴露的是从任务环境导出的信息,不访问标签或验证器状态。
5.1 轨迹分析
每张表报告基线、演化后 harness 及可配对记录上的绝对变化。
ITBench。 表 3 报告全部 40 个任务上的全基准分数与执行轨迹。演化把任务分数从 40.0% 提升到 75.0%,减少了轮次与假阳性,增加了真阳性,同时 shell 调用数量相当。
表 3:ITBench(GPT-5.4)全基准分数、执行轨迹与估计 API 成本对比(全部 40 个任务)。
| 指标 | 基线 | 演化后 | Δ |
|---|---|---|---|
| 全基准任务分数 | 40.0% | 75.0% | +35.0 pp |
| 每任务轮次 | 25.2 | 22.1 | −3.1 |
| Shell 调用 | 49.8 | 46.7 | −3.1 |
| 每任务成本 | $3.26 | $2.70 | −17% |
| 假阳性 | 0.79 | 0.33 | −0.46 |
| 真阳性 | 0.45 | 0.78 | +0.33 |
演化后的智能体在检查相当数量原始证据的同时,用更少的轮次得出更准确的结论。回归(regression)出现在本应终止于近因、上游搜索却仍在继续的情形。
EnterpriseOps-Gym。 表 4 报告全基准的任务成功率与执行轨迹。演化缩短了工作流并提高了验证器完成率。
表 4:EnterpriseOps-Gym(GPT-5.4)全基准任务成功、执行轨迹与估计 API 成本对比(103 个任务)。
| 指标 | 基线 | 演化后 | Δ |
|---|---|---|---|
| 全基准任务成功率 | 23.3% | 43.7% | +20.4 pp |
| 每任务轮次 | 18.12 | 9.87 | −8.25 |
| 工具调用 | 29.53 | 16.83 | −12.70 |
| 每任务成本 | $1.23 | $0.58 | −53% |
| 验证器通过率 | 34.5% | 72.8% | +38.3 pp |
schema 与参数修复针对工具选择;执行与结束契约针对不完整的工作流;自引用与关联提示在相互依赖的变更操作间保持状态。
AutomationBench。 表 5 报告完整的 GPT-5.4 执行记录对比。在完整的 GPT-5.4 任务集上,演化减少了不安全执行并改善了部分完成。
表 5:AutomationBench(GPT-5.4)执行记录与估计 API 成本对比(100 个任务)。
| 指标 | 基线 | 演化后 | Δ |
|---|---|---|---|
| 领域目标分数 | 57.1% | 83.2% | +26.1 pp |
| 平均部分得分 | 67.3% | 86.1% | +18.8 pp |
| 每任务轮次 | 16.35 | 11.98 | −4.37 |
| 每任务成本 | $0.14 | $0.10 | −29% |
| 有护栏违规的任务数 | 20 | 4 | −16 |
| 护栏违规总数 | 33 | 4 | −29 |
| 零分任务数 | 24 | 6 | −18 |
该 harness 把分诊放在变更操作之前,把日期锚定到沙箱时钟,并把算术与电子表格操作委托给确定性工具。我们无法从这些记录中隔离任何单个工具的贡献。
在全部三个基准上,被接受的编辑或修复了接口、或显式化了环境惯例、或编码了运营知识、或压缩了对可用证据的搜索。我们无法从配对对比中隔离单个补丁的因果贡献。
6 结论
我们的结果表明:当围绕固定模型的 harness 被适配到环境时,模型可以大幅改进。在 ITBench、EnterpriseOps-Gym 与 AutomationBench 上,StarHarness 学到了对工具接口的修复、环境惯例、运营知识与搜索压缩辅助。这些变更改进了全基准分数,泛化到被排除于演化之外的任务,并且无需重新演化 harness 即可跨 GPT 与 Qwen 模型家族迁移。在可测量的设置中,轨迹分析把增益与更短的工作流、更少的假阳性诊断和更少的不安全执行联系起来。
这些结果表明:对有状态的企业智能体而言,harness 演化是模型扩展(model scaling)之外一个实用的补充。搜索改变的是一个固定模型如何检索记录、调用工具、保持依赖、验证副作用。未来方向是通过强化学习共同演化 harness 与模型权重,让脚手架与策略共同专门化于企业交互协议。这可能产出更小、更高效的企业模型,并检验联合的 harness–权重优化能否以更低的推理成本匹敌或超越更大的模型。
译注:本文完整翻译了论文正文(摘要、第 1–6 节,含图 1–3 说明与表 1–5 全部数据)。省略部分:References 参考文献列表(25 条,原文条目见 sources/arxiv-starharness/source-full.md)以及 arXiv HTML 页面模板性内容(报错指引等)。本论文 HTML 版无附录。