
循环工程实战(Practical Loop Engineering)
我平时的工作方式,是同时并行跑着五到十个智能体。有些任务我非常乐意完全委托给智能体——只要我对它们的停止条件和约束有非常清晰的把握。而另一些任务,我会想盯得更紧一些,对智能体做的东西逐一做代码评审。
在这个背景下,你大概已经听说过**循环工程(loop engineering)**了。几个月前我写过一篇长文专门讲它。
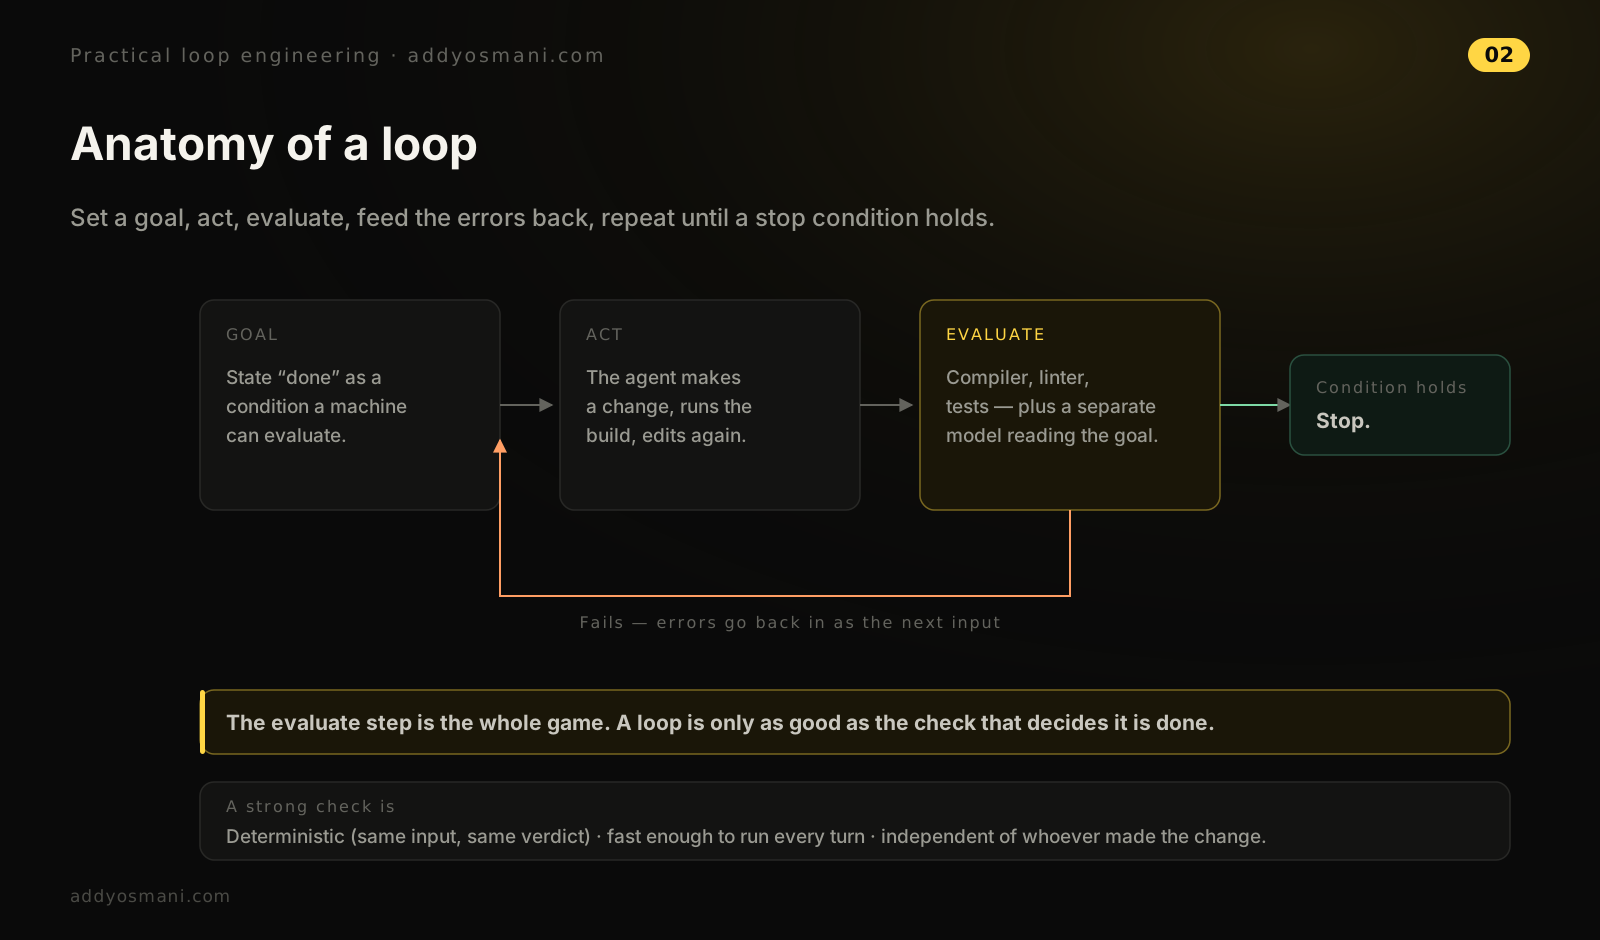
循环(loop)是一个自主的、自我纠正的反馈周期:AI 智能体反复行动、检验结果、调整方法,直到达成一个明确的目标
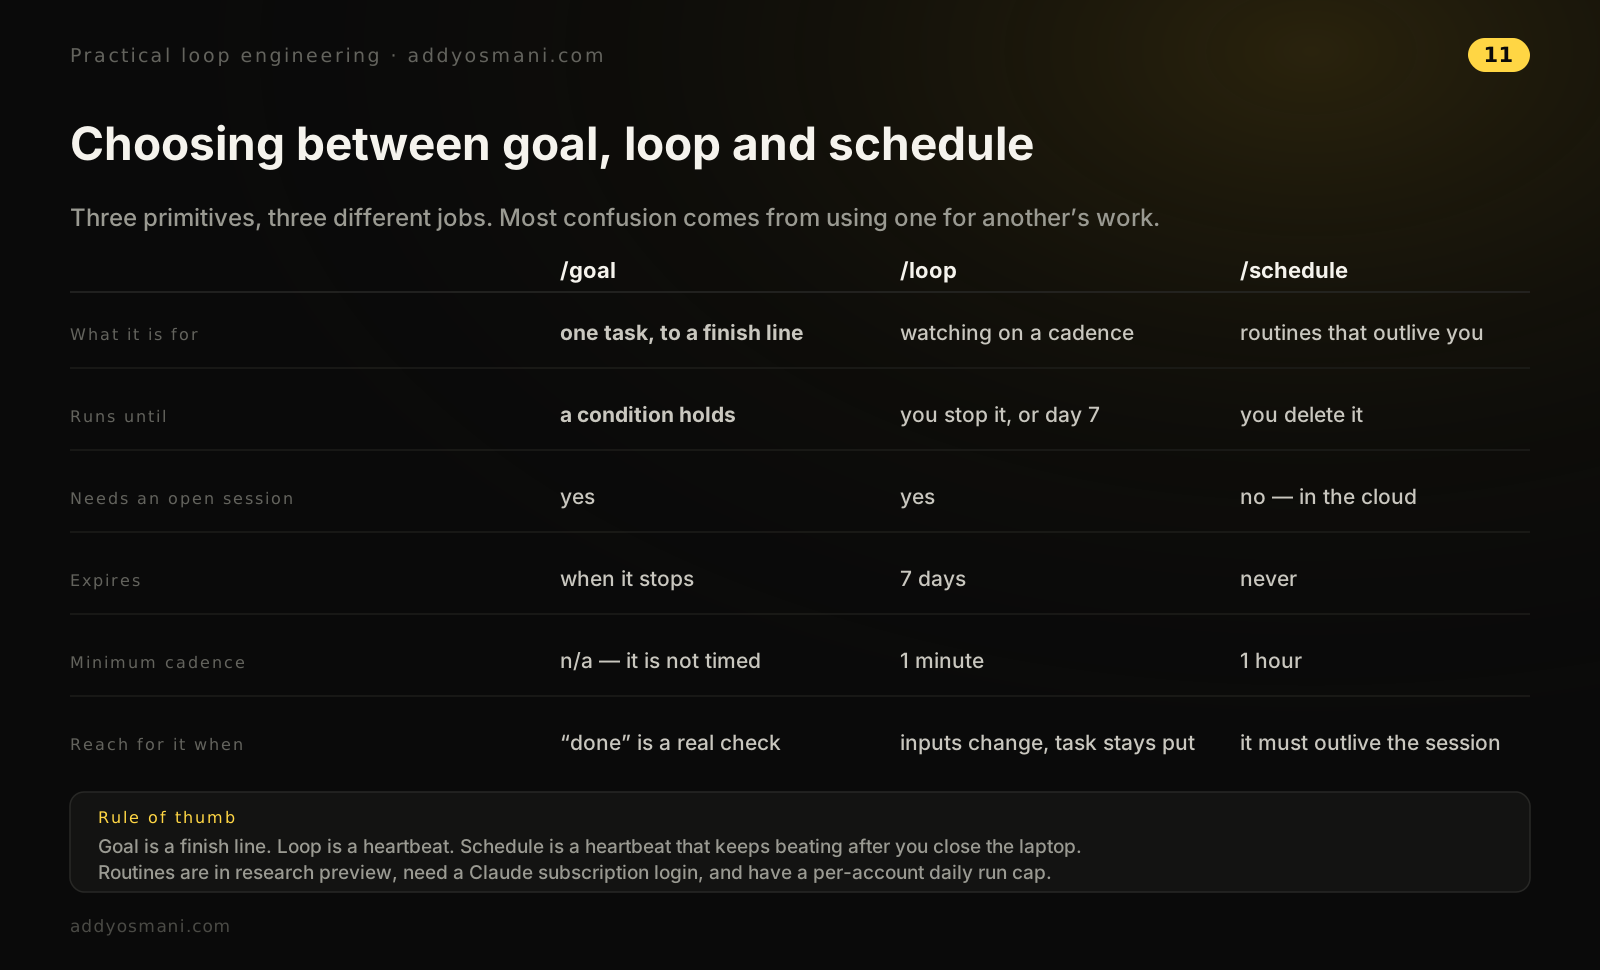
现在你基本上可以围绕两个核心原语来思考。在 Claude Code 里,你有一个 goal 原语,它能驱动一个有边界的任务一直往前推进,直到某个特定目标——一条可度量的终点线——被满足为止。然后是 loop,它按定时器或固定间隔重复运行,所以你可以用它来调度周期性的变更。
在原语还不是原语的时候
我还记得,在 Claude Code 和 Codex 把原语内置进来之前,循环工程在很大程度上就是自己搭一个 bash 循环,一个手搓的东西。我当时就是这么干的。你可能还记得今年早些时候,我们一批人在玩 Geoff Huntley 的 Ralph loop。我们做实验,互相分享工作流,分享什么好使、什么不好使——但那基本都是在各自的个人项目上,就算撞了墙,代价也不大,因为只是个人项目。
而随着我们逐渐看清循环工程的哪些模式、哪些侧面已经比较成熟,我认为我们对"怎么盯守(babysit)它"有了更清楚的认识。现在我基本可以信赖 Claude Code 和 Codex 里这些原语的产出。我们确实走了一段路。但与此同时你需要非常勤勉,因为如果你把循环丢在那儿不管,又没有认真想过最终目标和约束是否被良好定义,它可能把你留在一个很麻烦的状态里。这也是为什么"用不用它"需要看场景:一个没有用户、没有多少历史复杂度的常青代码库,和一个棕地的银行代码库,答案是不一样的。
Claude Code 团队怎么框定循环
Claude Code 团队发表了他们对四类循环的划分,和我使用这些原语的方式对得上(他们的文章)。在进入正文之前,先放我的快速总结:
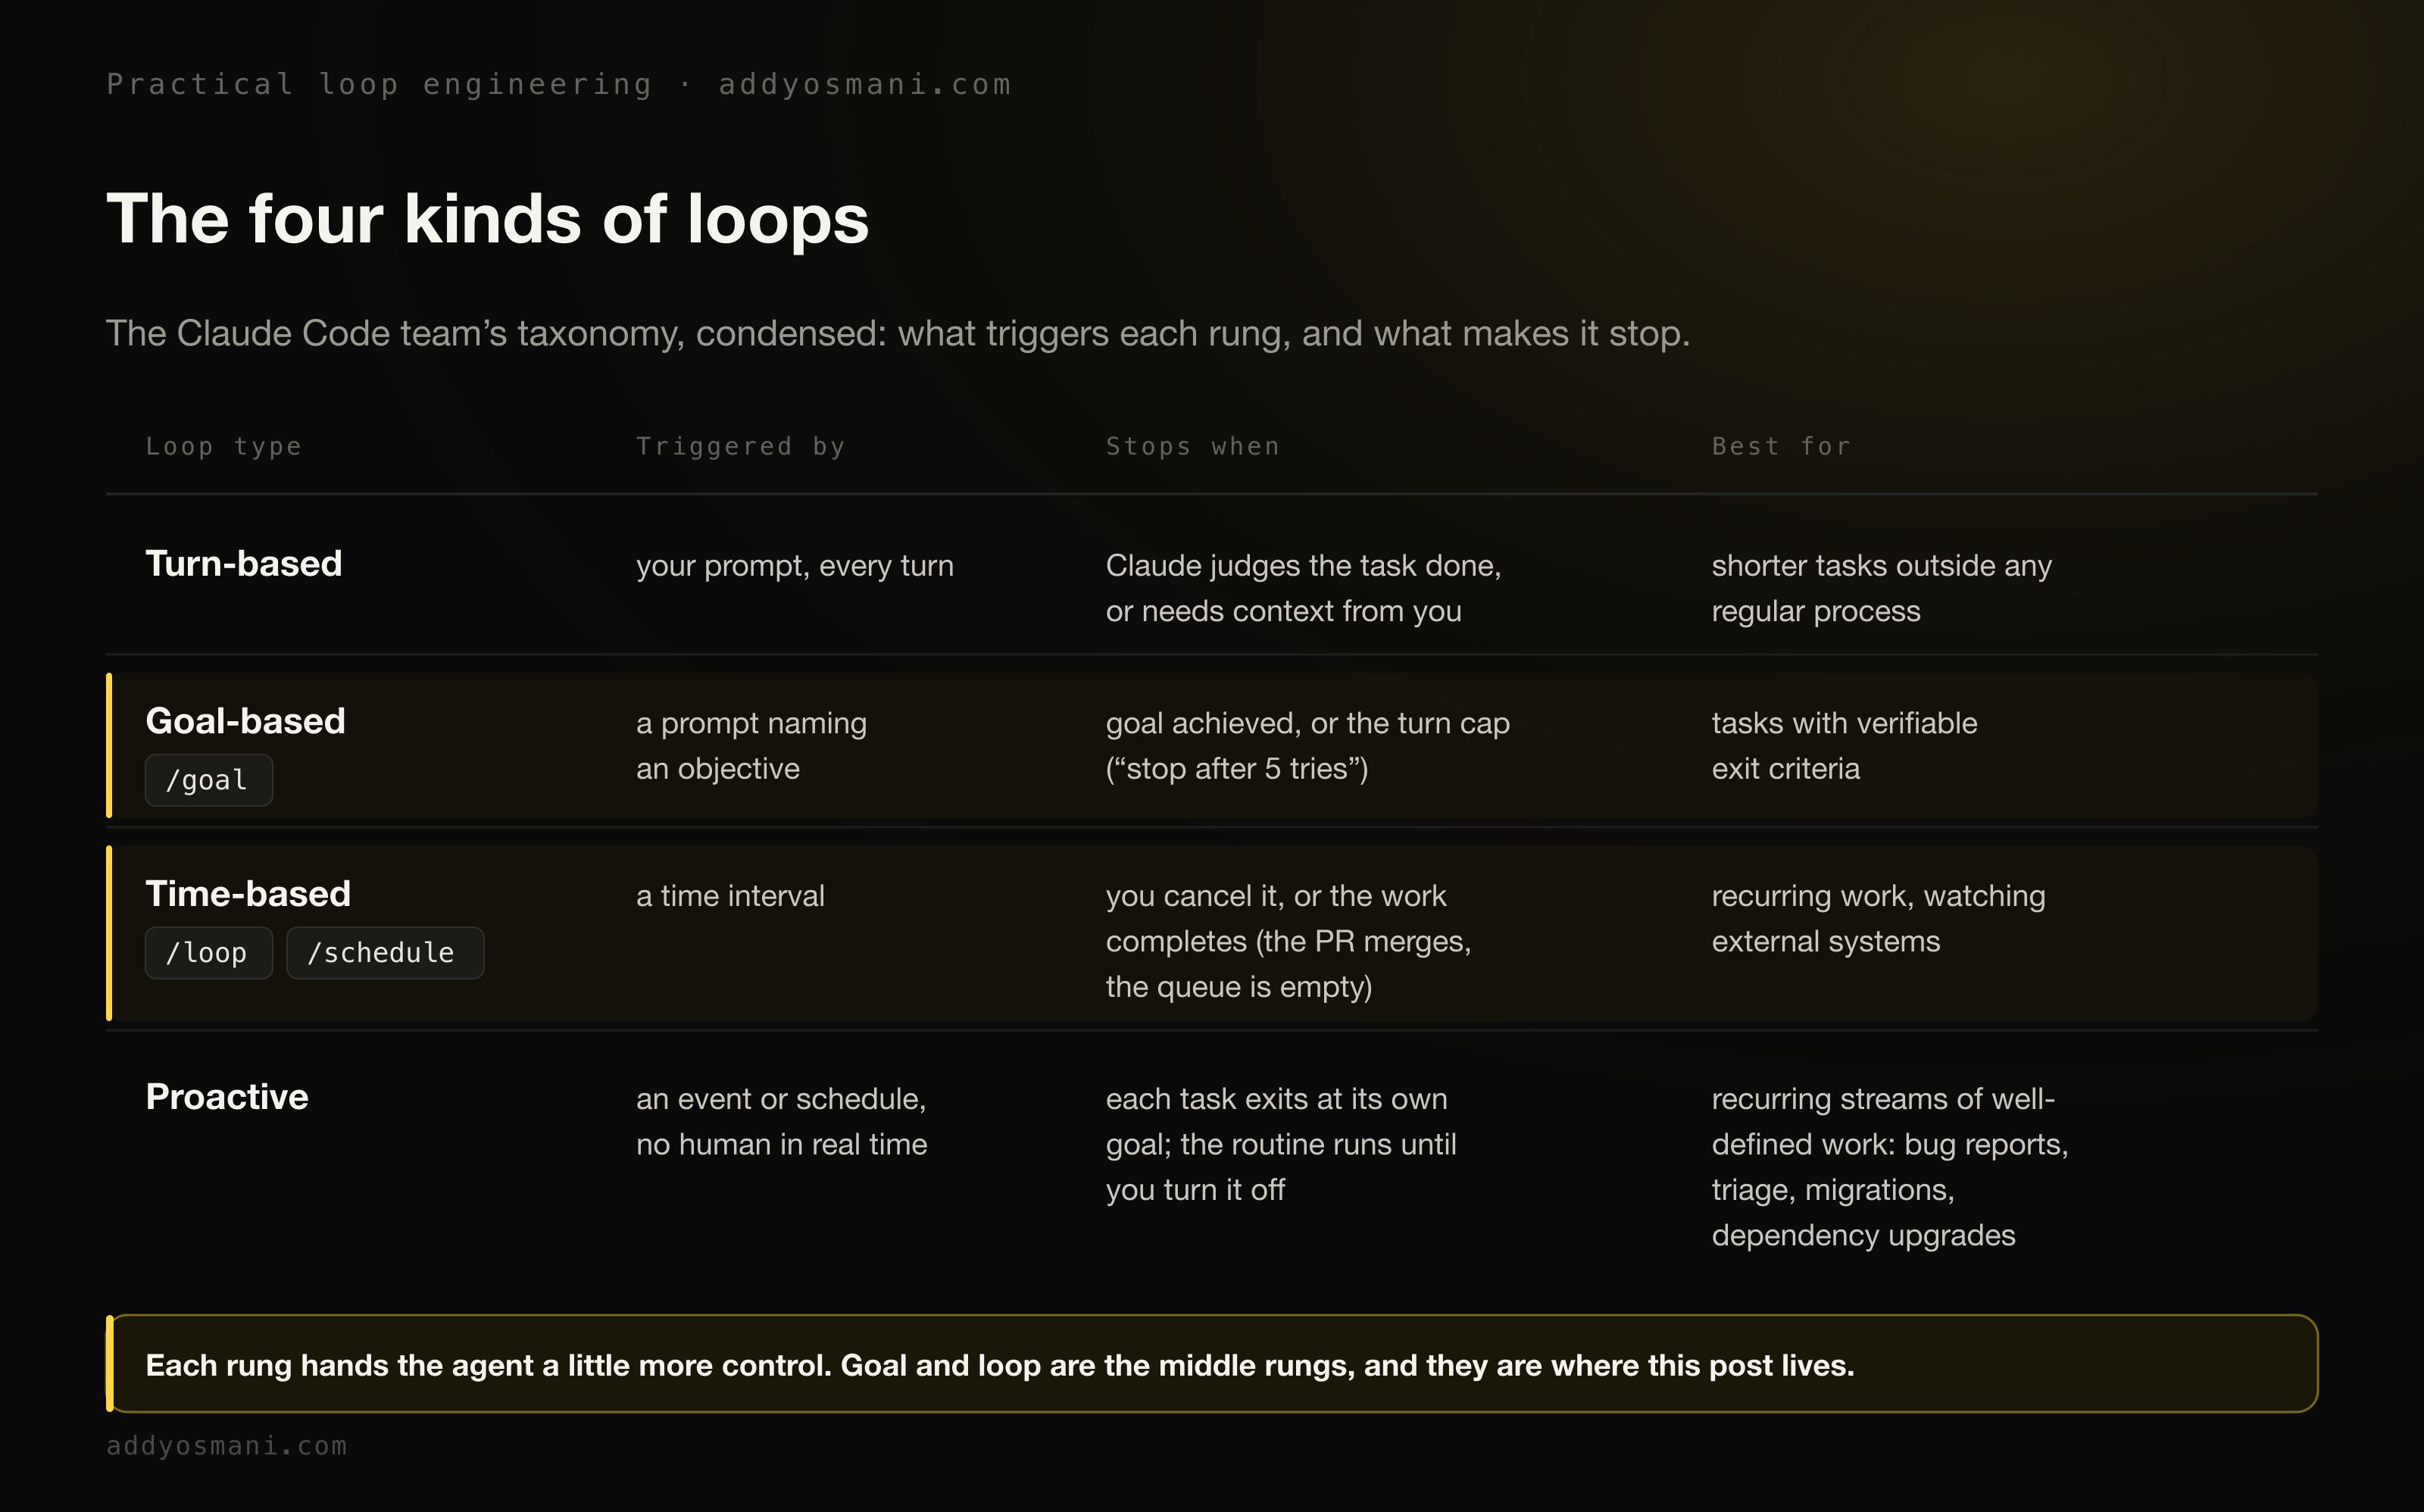
在 Claude Code 团队,我们把循环定义为:智能体重复工作周期,直到满足某个停止条件。我们按几个维度对循环分类:如何触发、如何停止、使用哪个 Claude Code 原语、每一类最适合什么任务。不是所有任务都需要复杂的循环;从最简单的方案开始,有选择地使用这些模式。
你发出的每一个提示词都会启动一个手动循环,由你来指挥每一轮。Claude 收集上下文、采取行动、检查自己的工作、必要时重复,然后给出回应。我们把这称为智能体循环(agentic loop)。比如,让 Claude 做一个点赞按钮。它读你的代码、做出修改、跑测试,然后把它认为可用的东西交回来。接着由你手动检查这份工作,再写下一个提示词。
他们的文章把每一档都过了一遍。
关于目标型循环(goal-based loops):
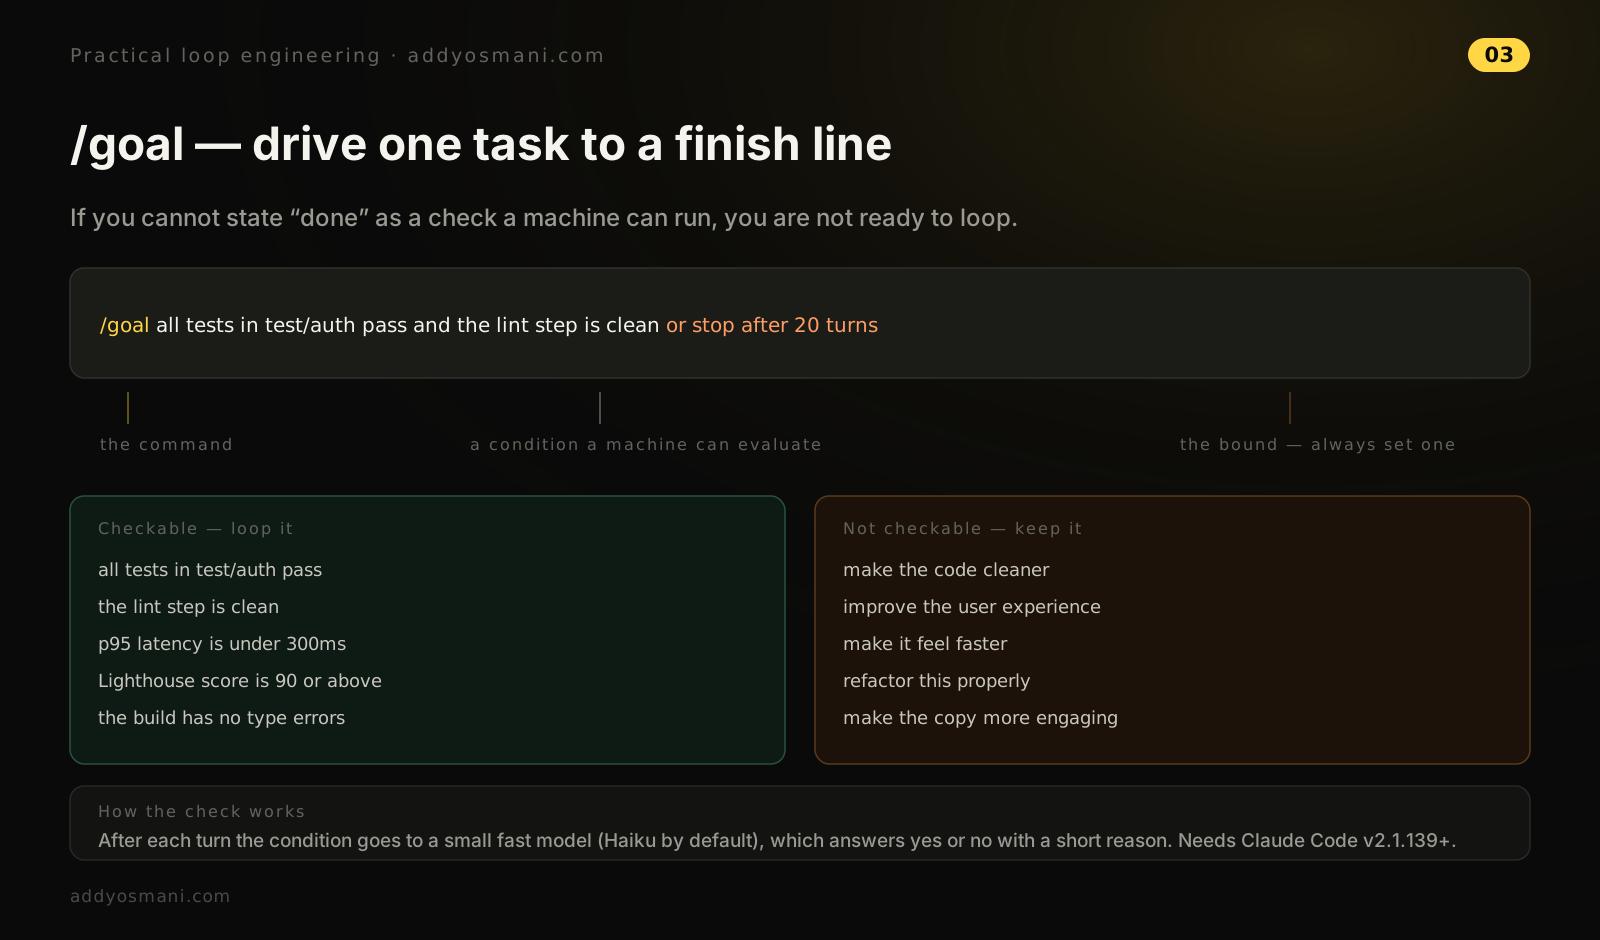
有时候,一轮是不够的,尤其是更复杂的任务。智能体在可以迭代时表现更好。你可以通过用 /goal 定义"完成长什么样",来延长 Claude 持续迭代的时间。当你定义了成功判据,Claude 就不必自行判断什么算"足够好"、然后过早结束循环。每次 Claude 想要停下来时,一个评估器(evaluator)模型都会检查你的条件,把它送回去继续干,直到目标达成,或者达到你设定的轮数上限。这就是为什么确定性的判据——比如通过的测试数量、越过某个分数阈值——如此有效。例如:/goal 把首页 Lighthouse 分数拉到 90 或以上,尝试 5 次后停止。
关于定时型循环(time-based loops):
有些智能体工作是周期性的:任务不变,只有输入在变。比如每天早上总结 Slack 消息。另一些工作依赖外部系统,而与外部系统对接的一种简单方式,就是按间隔去检查它、对变化做出反应。比如一个 PR,它可能收到代码评审,也可能挂掉 CI。对于这些,你可以用 /loop 来触发 Claude 的运行,它会按间隔重跑一个提示词。例如:/loop 5m 检查我的 PR,处理评审意见,修复挂掉的 CI。/loop 跑在你自己的电脑上,关机它就停。你可以通过创建 /schedule 云端例程(routine)把循环搬到云上。
关于主动型循环(proactive loops),最顶上那一档:
触发方式:事件或计划任务,没有人类实时在场。停止判据:每个任务在目标达成时退出;例程本身一直运行,直到你关掉它。最适合:定义良好的周期性工作流:bug 报告、issue 分诊、迁移、依赖升级。用量管理:把例程路由到更小更快的模型,把判断类决策留给最强的模型。
他们的验证建议值得整段搬过来,因为它把人工检查变成了 Claude 自己执行的东西:
---
name: verify-frontend-change
description: Verify any UI change end-to-end before declaring it done.
---
# Verifying frontend changes
Never report a UI change as complete based on a successful edit alone.
Verify it the way a human reviewer would:
1. Start the dev server and open the edited page in the browser.
2. Interact with the change directly. For a new control (button, input,
   toggle): click it, confirm the expected state change, and screenshot
   before/after.
3. Check the browser console: zero new errors or warnings.
4. Use the Chrome Devtools MCP, run a performance trace and audit
   Core Web Vitals.
If any step fails, fix the issue and rerun from step 1 - do not hand
back partially verified work.
Goal
我使用 goal 的方式,是用它把某件具体的工作一直做到"可证明地完成"。比如,你可以用一个 goal 说:确保这个体验在五秒内加载完成,一直做到达标为止。它会持续用一个独立的评估检查,反复确认完成判据是否已被满足。更好的做法是把用什么工具来度量也写得更具体。
至于我真跑到底过的 goal,有这么几件事。我用 goal 批量过 GitHub issues:评审并关闭最近 10 个 issue,或者评审并把最近 10 个 issue 往前推一步,诸如此类。这算半开放式的,对吧?还有:把这个页面加载速度提升 50%。有时候效果很好,有时候不行,但关键就在于实验。
Loop
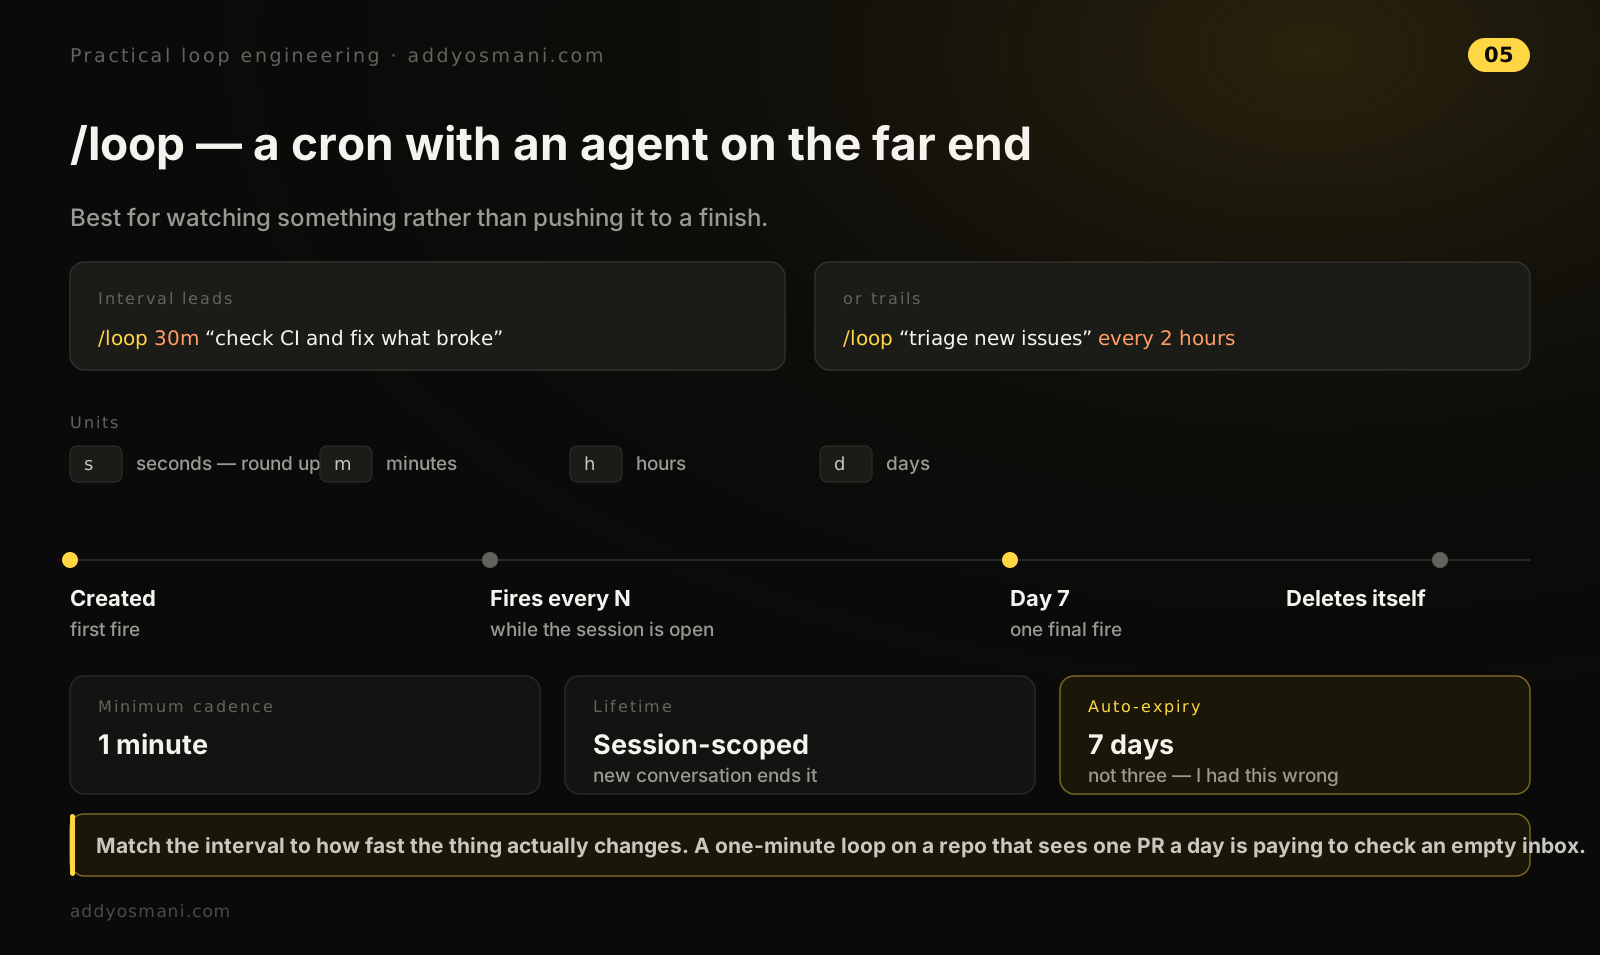
Loop 更像一个调度器,它持续盯着某个东西,或者按某个节奏重复执行一个模式。可以把它想成一个 cron。它最适合做轮询日志、监控外部状态这类事。你也可以用它来做定期检查。如果有一些你发现自己按某个节奏反复在做的任务,loop 很适合。
我委托什么,我盯什么
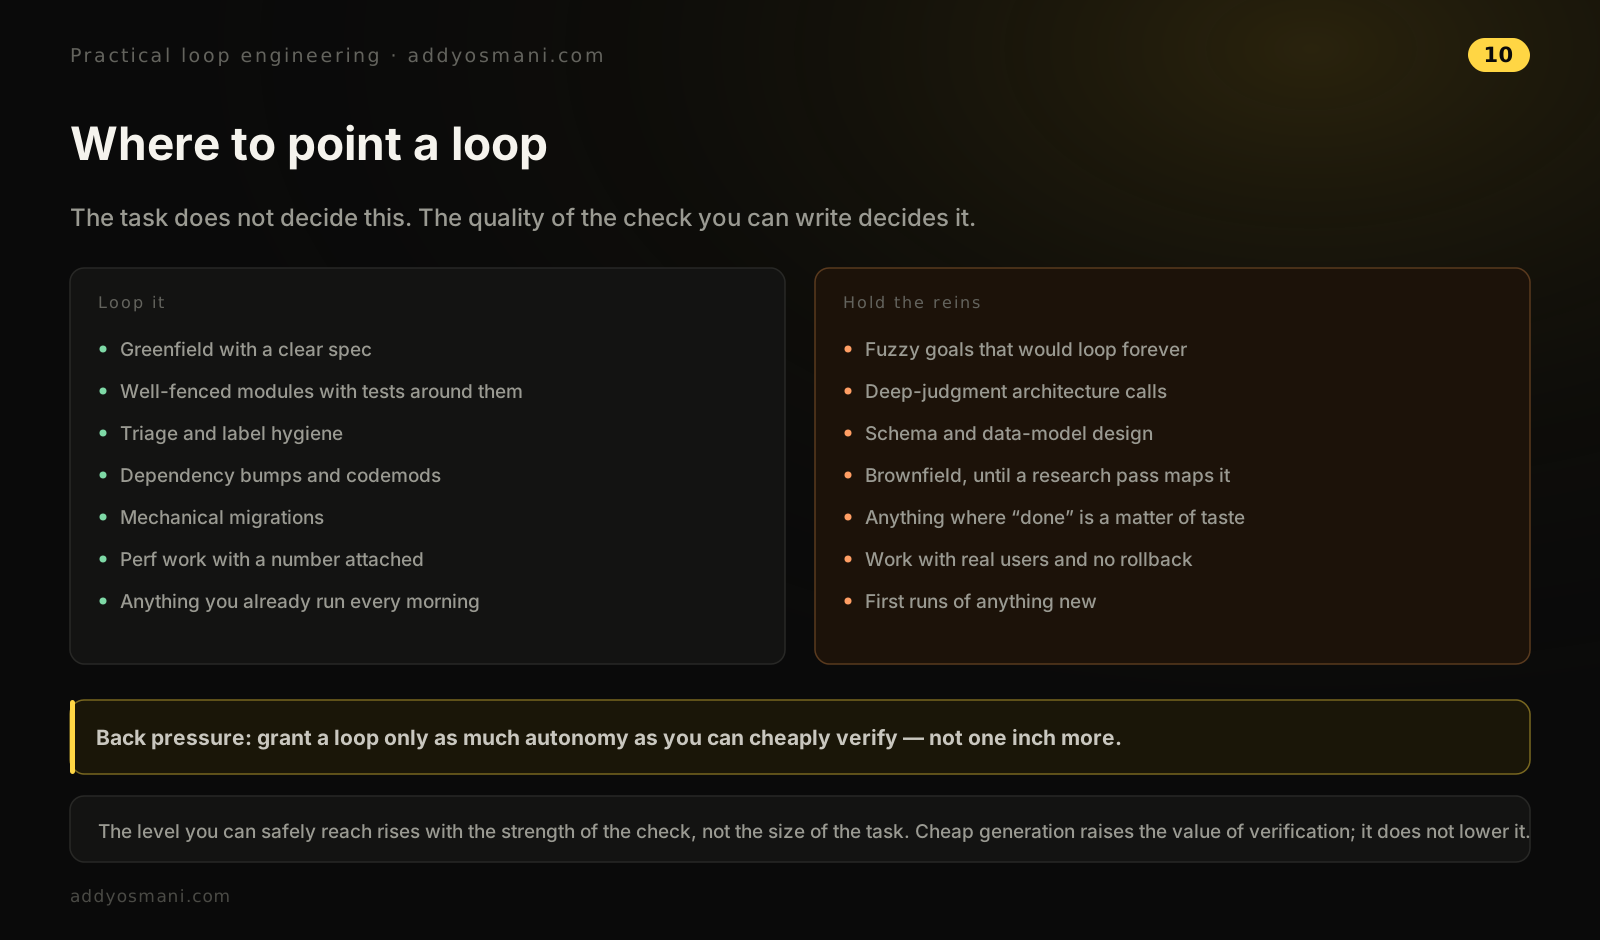
就我而言,我每天大概会用五到十个智能体。最典型的情况是并发峰值在五个左右。其中一些任务是相对安全的:比如,嘿,我实现了这个功能,去把文档写了;或者去复查一下测试覆盖是否充分;这一类。如果我在处理一个更复杂的问题,或者某件事上我明知即使给了一份不错的 spec——至少我自认为不错——也给了停止条件,它仍有相当概率做不到处处正确,我就会盯得更紧。而如果任务哪怕只是稍微碰到一点敏感的东西——无论是我给了它某个系统的访问权限,还是这个功能恰好触及身份认证,或者跟安全、金融相关——我一定会盯得很紧。
总的来说,我确实认为我们会走到一个大家越来越放心委托的阶段,前提是他们有清晰的方式去验证目标或停止条件已经达成。但你仍然需要看代码、看生成出来的那个东西,确认它够得上你的标准。
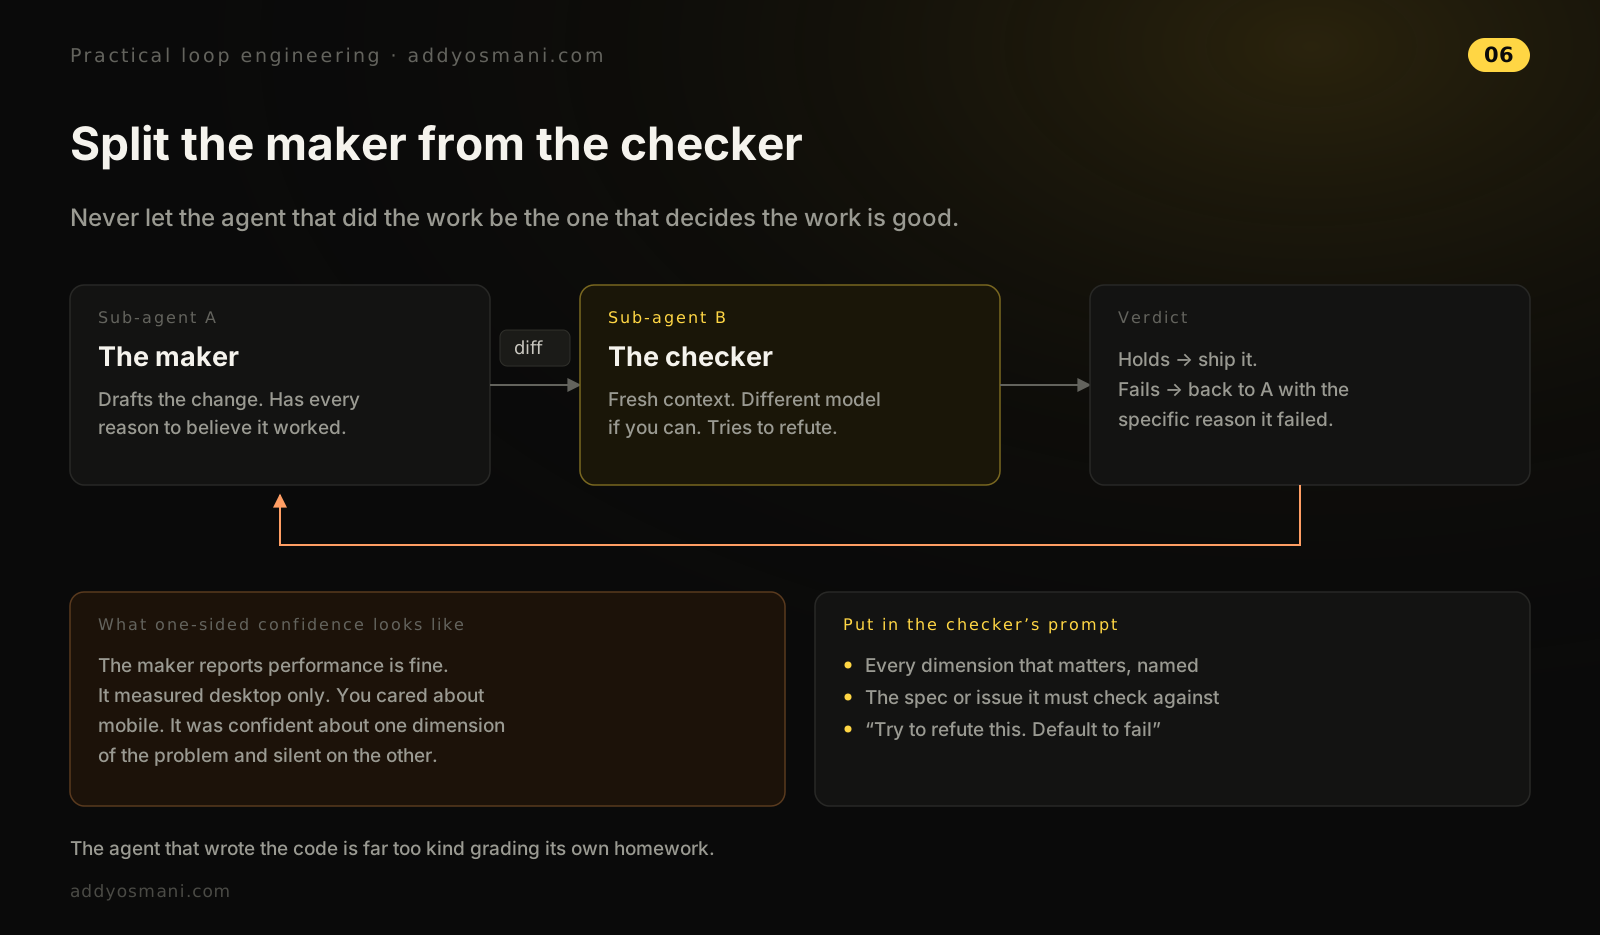
这里还有一个要紧的习惯:不要让干活的那个智能体自己判定活儿干得好。一个子智能体起草变更,另一个独立的子智能体来验证。
有时一个智能体会对某件事很自信,而一个验证智能体能抓住它没料到的问题。比如它认为自己生成的体验基线性能其实还行,但它只在桌面端评估了性能,而你真正在乎的是移动端体验。这可能意味着智能体在问题的一个维度上非常自信,在另一个维度上却不然。
这一条我是吃过亏才学会的。我当时想搞清楚:有没有什么我们遗漏的东西,是用户没有在 issue 跟踪器或评论里直接反馈给我们的?于是我让它去看了看一些竞品,整理一份清单,并在本地——没有 push——起了一些 PR,展示补上这些差距大概长什么样。我差点就把其中一些改动推上去了。但我其实没有足够仔细地看它们。我通读了它的调研,却没有足够仔细地看实现。也就是说,我委托了任务,但差一点连判断也一并委托了出去。等我真正细看那些改动,我意识到它会给我们的用户引入大量额外复杂度,而在我个人看来,换来的收益并不多。所以我觉得你有时需要检查自己:你没有把品味和判断委托给你的智能体。你委托的是任务,然后你要真的回头核对它是否够得上你的标准。
顺带说一句,goal 背后的那个评估器并不是这里说的验证者。它完全不看内容本身好不好——任何意义上都不看。它做的只是检查对话记录(transcript),看你指定的硬规则有没有被满足。
/goal Refactor the data-fetching layer in Dashboard.tsx until Lighthouse performance score is >= 92 and LCP is under 1.8s as shown by the Lighthouse CLI output. Do not change the public API of any hooks. Each turn must improve at least one reported metric; abort if two consecutive turns show no improvement. Stop after 10 turns.我每天在跑的工作流
我每天都在跑的一个工作流:我有一个很受欢迎的开源仓库叫 Agent Skills。它有超过 80,000 个 star,直到不久前,我们每天要评审的 pull request 多的时候能到 80、90 个。所以每天我都得花时间去盯这个仓库。现在有了 loop,你可以说:每 24 小时或每 12 小时,检查这个 GitHub 仓库有没有新开的 issue,给出一份按紧急程度排列的摘要,或者做一轮初审,诸如此类。
/loop every 1h "Check the GitHub repository for any new open issues. Provide a bulleted summary of their urgency."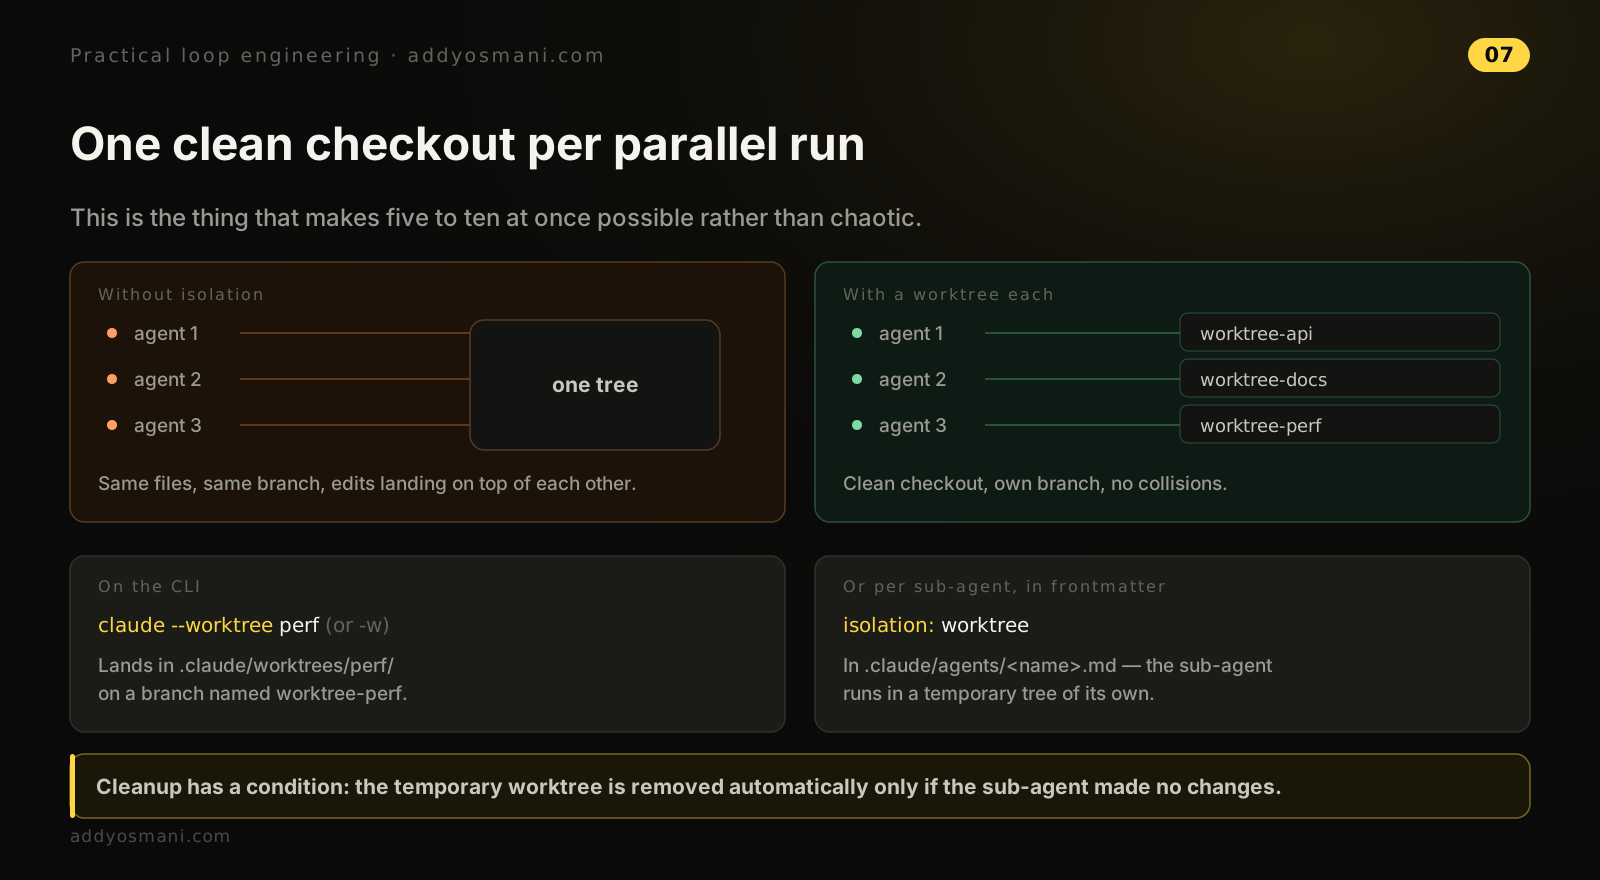
组合 loop 与 goal
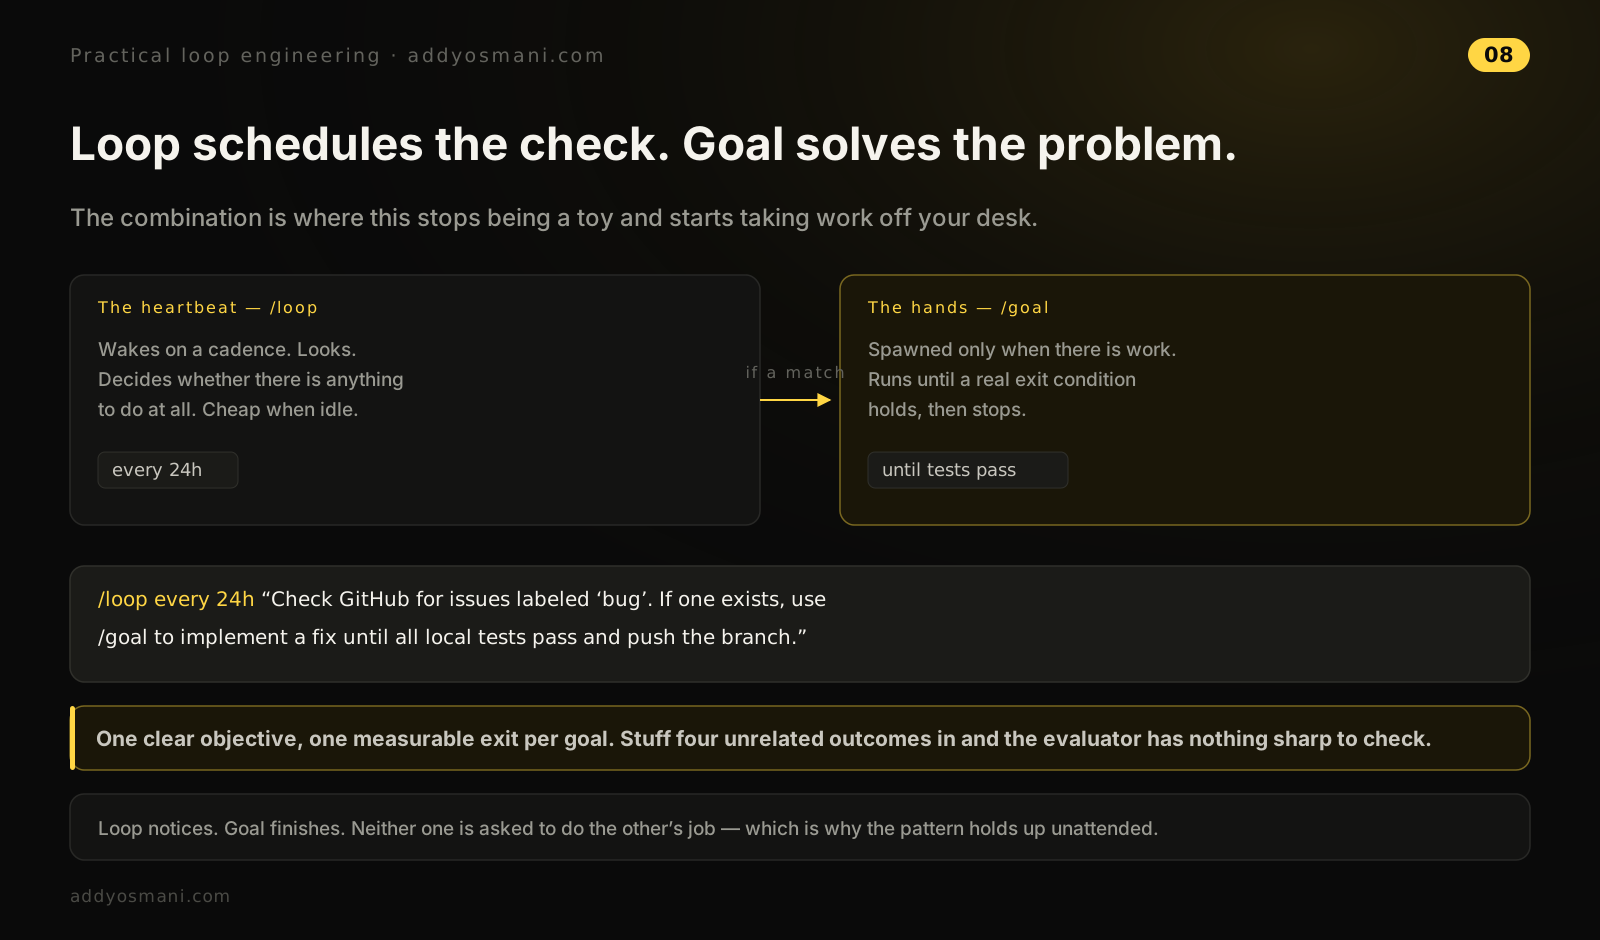
你还可以把 loop 和 goal 组合起来。用 loop 调度一次检查,再用 goal 解决问题。比如你可以说:每 24 小时循环一次,检查 GitHub 上打了 bug 标签的 issue;如果存在,就用 goal 实现一个修复,直到本地测试全部通过,然后推送分支。
/loop every 24h "Check GitHub for issues labeled 'bug'. If one exists, use /goal to implement a fix until all local tests pass and push the branch."不过也要记住,goal 里能塞多少东西是有上限的。
他们的文章里还有一个组合示例,展示了这一切正在通往哪里:
上面这些原语,加上 Claude Code 的其他能力——比如 auto mode 和动态工作流(research preview)——可以组合成一个处理长时间运行工作的循环。比如,要处理源源不断的反馈,你可以用:/schedule(research preview)跑一个例程去检查新报告;/goal 定义"完成"长什么样;用 skills 记录如何验证。动态工作流编排一批智能体,对每份报告做分诊、修复、评审修复。auto mode 让例程运行时不必停下来请求权限。合在一起,一个提示词可能长这样:/schedule 每小时:检查 project-feedback 频道的 bug 报告。/goal:在这一轮发现的每份报告都被分诊、处理并回复之前不要停。修 bug 时,用一个工作流在三个并行 worktree 里探索三种方案,并让一个裁判智能体做对抗式评审。
这套分诊系统实际做到了什么
在 PR 分诊里,当 loop 和 goal 一起为我工作时,我最终得到的是一个让我能持续接收 PR 和 issue 的系统:每天都能稳稳压住涌到我盘子里的东西,尤其是能做交叉引用。这对我来说是件大事。如果我要推进一个具体目标——嘿,我们要重做系统的这一部分,我需要确保所有碰到这部分的 issue 都因为这次重做而被关闭,或者确保我们没有踩到别人的脚趾——我可以把这件事定义清楚。
计划任务对于"定期评审新 PR、关掉明显不合适的东西"非常有用。举一个好的停止条件的例子:我们有一套贡献指南,里面写了诸如"我们目前不接受翻译类贡献"。
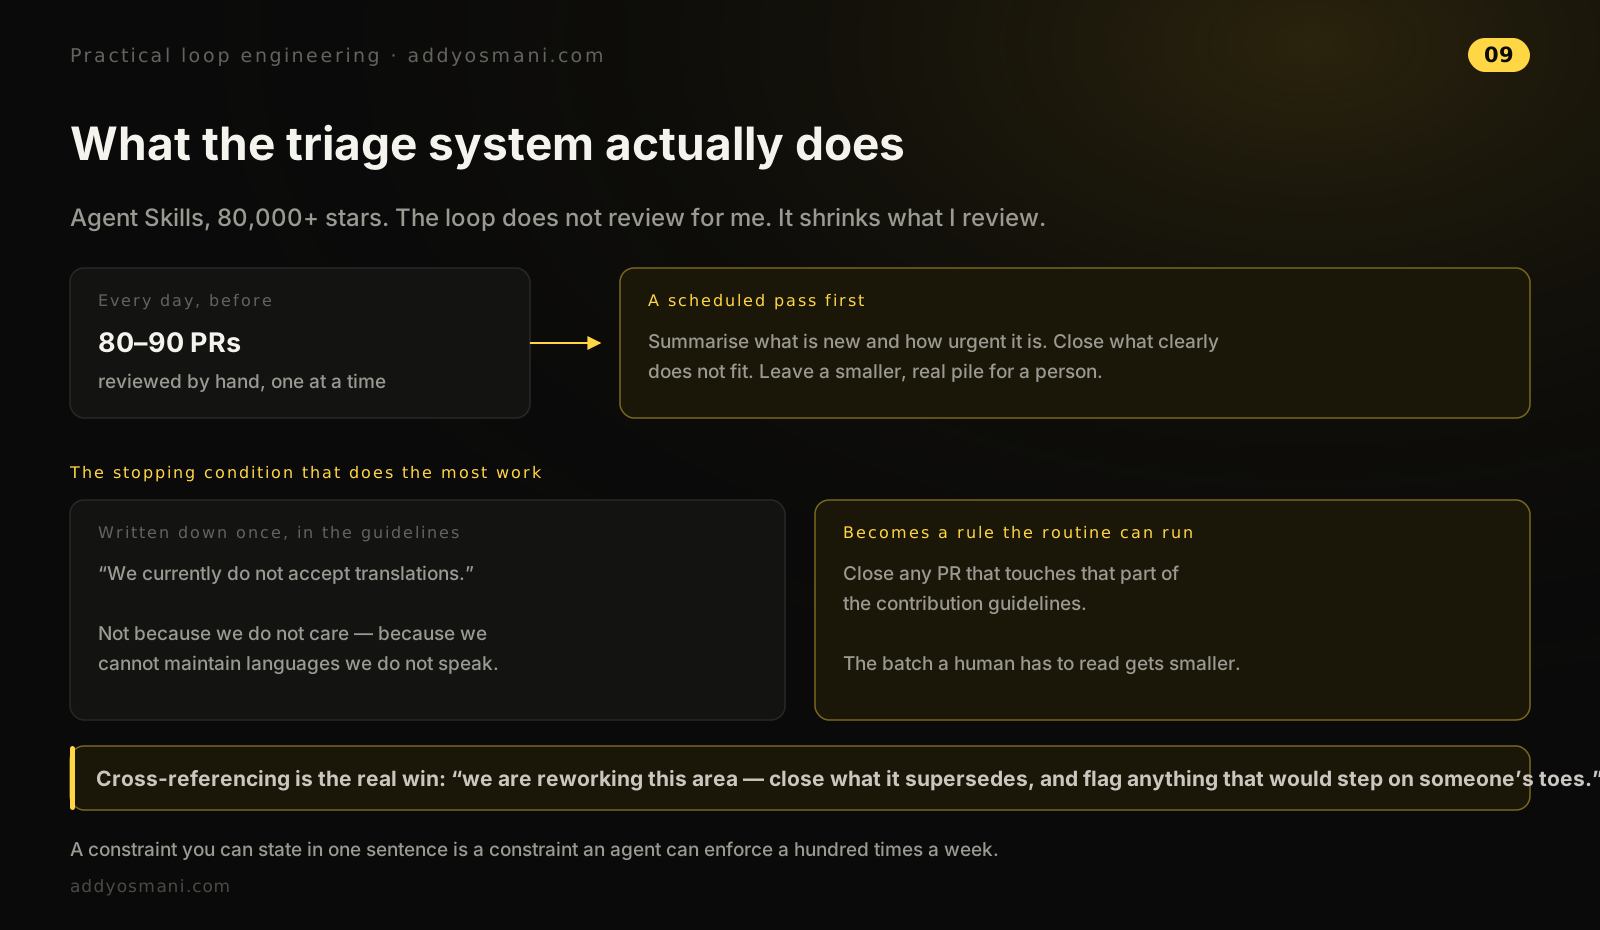
不是我们不在乎,而是它们很难维护——因为送进来的语言我们往往并不会说。所以如果我们告诉它:凡是触及贡献指南这一条的 issue 或 PR 一律关闭,这件事放在计划任务上它能做得非常好。这样一来,我们真正需要人工评审的那一批就变小了。
循环买不来什么
经常有人问我,循环工程不适合什么。总的来说,如果你对"终态/完成/好"在你的场景里意味着什么没有清晰的概念,它可能就不是适合你工作的模式。比如,一个模糊的 goal 是"一直改到这个 UI 设计足够好"。这是什么意思?对谁来说好?怎么评估?需要人类品味、主观设计或开放式创造性探索的任务不适合。而当你对目标有相当清晰的把握时,我认为循环是一个值得考虑的好选项。
细则
循环在原地空转的一个经典信号:同一条命令被反复尝试,结果毫无变化。同一条命令第三次执行、和第二次相比毫无变化——多半就该停了。
有一条细则值得知道。周期性循环在创建七天后过期。我之前一直跟别人说是三天,其实是七天。另外 loop 是 session 作用域的:你开一个新对话它们就停了——不过用 --resume 或 --continue 恢复那个 session,还在七天窗口内的周期任务会被带回来。如果你需要某个比 session 活得更久的东西,用 /schedule 让它跑在云端。
如果有一个检查你每天早上都在手动跑,那它就是你的第一个循环。我的是那堆 pull request。
本文最初发表在我的 Substack。