
我们正在更改开发者生产力实验的设计
METR 此前发表过一篇论文,使用 2025 年 2 月至 6 月的数据发现:在经验丰富的开源开发者中,使用 AI 工具会导致完成任务的时间变慢 20%(译注:即被广泛引用的"慢 19%"研究,19% 为点估计,此处原文行文取整为 20%)。
为了理解 AI 对开发者生产力的影响如何随时间变化,我们在 2025 年 8 月启动了一项新实验,扩大了开发者池子,并使用最新的 AI 工具。
不幸的是,根据参与者反馈与问卷调查,我们认为新实验的数据对"AI 工具当前的生产力效应"给出的是不可靠的信号。首要原因是:我们观察到,选择不参与研究的开发者显著增多,因为他们不愿意在没有 AI 的条件下工作——这很可能使我们对 AI 辅助加速的估计被系统性压低。此外我们认为还存在因报酬降低(时薪从 150 美元降到 50 美元)带来的选择效应;而对于并发使用多个 AI 智能体的那部分开发者,我们对每个任务耗时的测量也不可靠。
基于与研究参与者的交流,我们认为:开发者现在(2026 年初)从 AI 工具获得的加速,可能比我们 2025 年初的估计更大。然而,由于实验中的选择效应,我们的数据对这一增幅的大小只构成很弱的证据。
我们的原始结果显示出一些加速的迹象。2025 年初的研究发现使用 AI 使任务耗时延长 19%,置信区间为 +2% 至 +39%。而对参与了后续研究的原班开发者子集,我们现在估计的加速为 -18%,置信区间 -38% 至 +9%;在新招募的开发者中,估计加速为 -4%,置信区间 -15% 至 +9%。
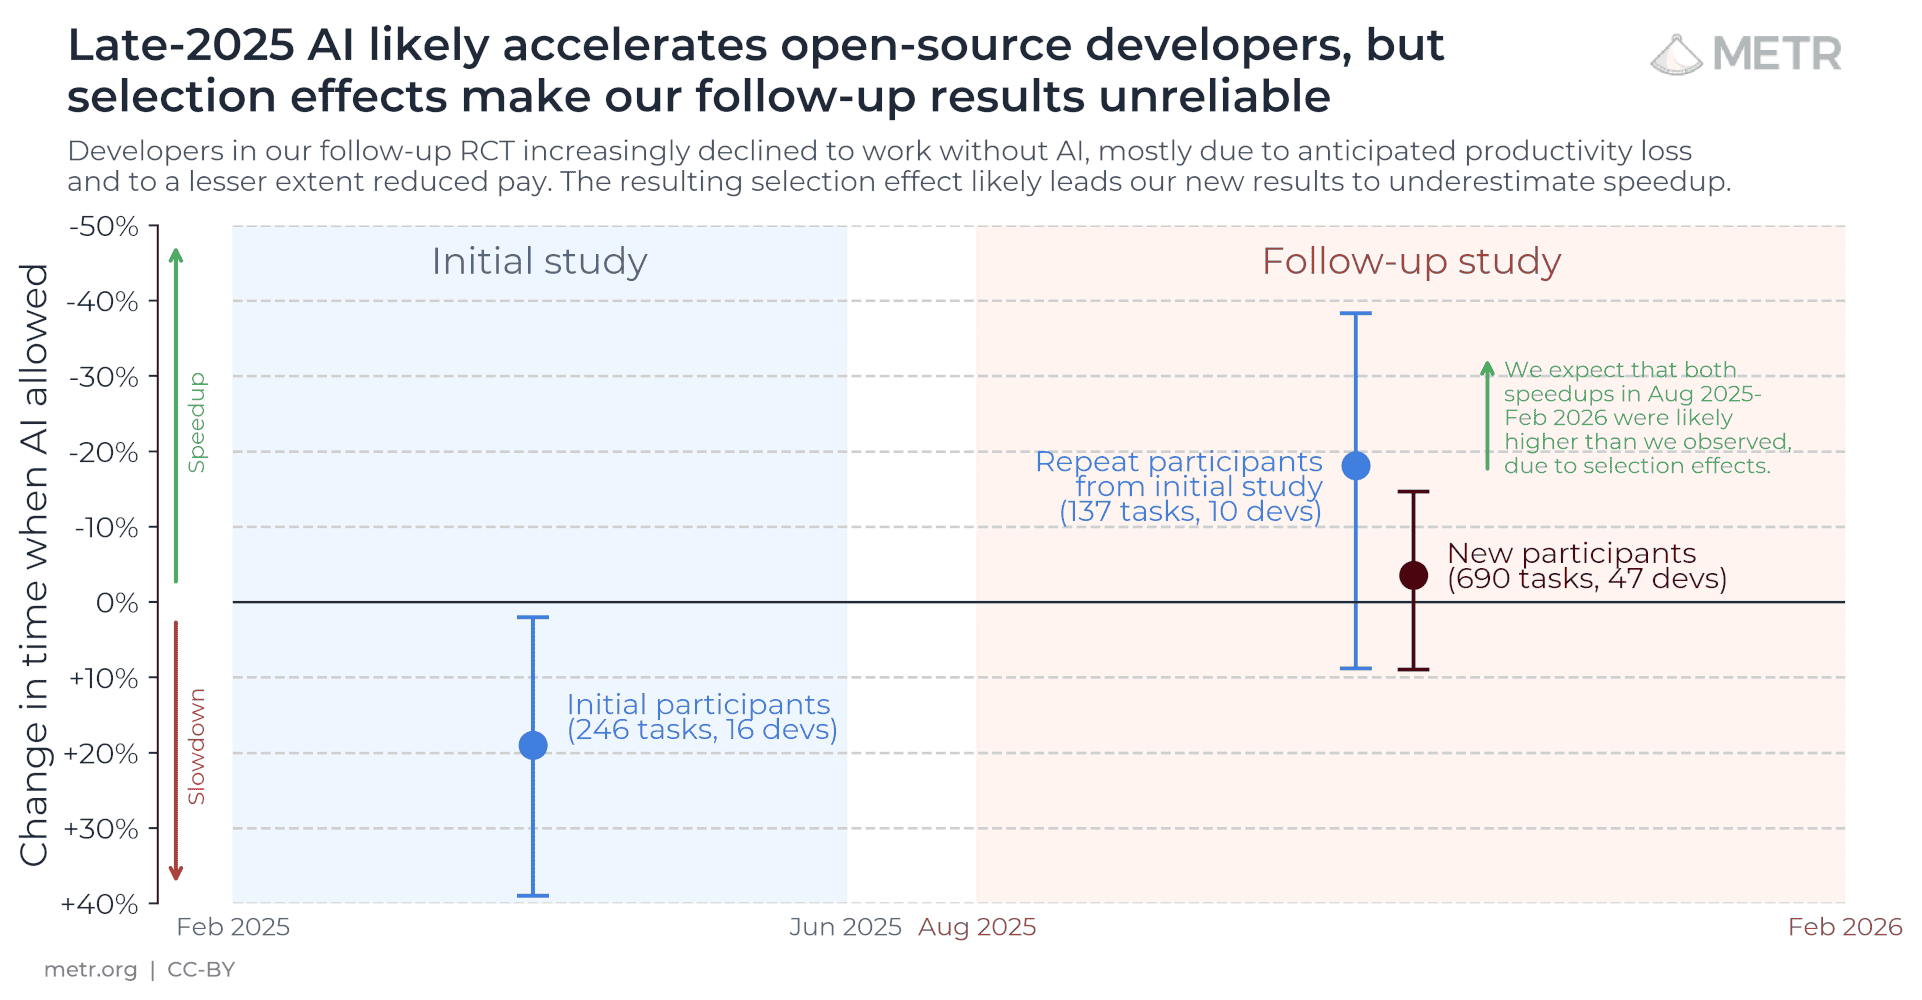
图:三组估计的置信区间时间线。纵轴为"允许用 AI 时的耗时变化"(负值 = 加速):2025 年初研究的初始参与者 +19%(246 个任务、16 名开发者),2025 年末后续研究中的原班开发者 -18%(137 个任务、10 名开发者)、新招募开发者 -4%(690 个任务、47 名开发者)。METR 在图中标注:由于选择效应,两组后续加速的真实值很可能高于观测值。
但在那些被实验"选择掉"的开发者和任务上,真实加速可能高得多。一些开发者自报了非常高的加速——不过正如我们在早前研究中记录的,这类自我估计可能相当不可靠。
鉴于这些选择效应的严重性,我们正在着手修改研究设计。下文将提供更多细节,并介绍我们研究 AI 对开发者生产力影响的其他手段。
AI 的广泛采用,使任务级生产力测量变得更难
我们的第二项研究自 8 月开始,包含原研究的 10 名开发者,加上从更多样化的开源项目中新招募的 47 名开发者。参与者的报酬为每小时 50 美元。
与初始研究一样,开发者需要预先指定自己打算做的每个任务,然后提交任务描述参与随机分配。每个任务被分到"允许用 AI"或"禁止用 AI"条件。开发者记录完成任务所花的时间,我们据此比较典型任务在有 AI 和无 AI 条件下的平均耗时。
整个 2025 年,开源开发者中智能体工具(如 Claude Code 和 Codex)的使用不断增加。AI 的广泛采用对我们的研究产生了两个重要影响:
开发者的招募与留存变难了。 越来越多开发者表示,他们不愿意在 50% 的工作中不用 AI——即使我们付每小时 50 美元、让他们做自己选择的任务。因此,我们的研究系统性地漏掉了对 AI 价值预期最乐观的那批开发者。
开发者提交任务时变得更挑了。 问卷显示,30% 到 50% 的开发者告诉我们,他们选择不提交某些任务,因为不想在没有 AI 的条件下做这些任务。这意味着我们系统性地漏掉了预期 AI 增益最高的任务。
这两个效应加在一起,使得上文报告的估计很可能是 AI 对这些开发者真实生产力效应的下界。选择效应似乎只影响少数开发者和任务,这限制了偏差的程度;但我们很可能缺失了 AI 最积极采纳者的数据,而他们恰恰可能是最值得关注的人群。随着 AI 能力持续增长、开发者预期水涨船高,这些效应只会愈发剧烈,进一步限制这种研究设计的效度。
基于访谈和问卷,我们认为选择效应增强的主因是开发者对 AI 增益的预期变高了。不过第二项研究的报酬也更低(每小时 50 美元 vs 原研究的 150 美元),这很可能也加剧了选择。
我们还注意到一些其他问题,尽管我们判断其严重程度较低:
- 一些开发者表示,用智能体 AI 时他们尝试的任务类型变了,会倾向于发挥 AI 的长处。这有两个后果:(a) 研究内与研究外的任务选择不同;(b) 由于任务类型的替换,研究内的时间差可能无法代表价值差。
- 一些开发者表示,同一任务在允许 AI 与禁止 AI 条件下的最终产出质量不同——例如主观代码质量、或他们选择编写的文档和测试的数量。
- 一些开发者在任务被分到禁止 AI 条件后更不愿意完成它。有一位开发者没有完成任何被分到禁止 AI 条件的任务。
- 一些开发者反映,使用智能体工具时很难报告任务耗时,因为他们经常在等智能体干活时去做别的无关任务。
综合起来,这些问题使我们的中心估计难以解读。我们认为它很可能不是 AI 工具对这些开发者真实生产力影响的好代理。
部分开发者原话
"我很纠结。我想帮忙为这个问题提供最新数据,但我也真的很喜欢用 AI!"——一位原 2025 年初研究的开发者,在被邀请参加 2025 年末研究时说。
"我发现我在挑 issue 上有严重偏向……我会回避那种 AI 两小时能搞定、我自己要花 20 小时的 issue。如果这种任务被随机到禁止 AI 组,我会非常痛苦。"——一位新研究的开发者,谈选择提交哪些任务时的选择效应。
"如果非要用老办法干太多活,我的头会炸掉。就像已经习惯了打 Uber 之后,突然又要走路穿过整座城市。"——另一位新研究的开发者(谈及选择提交哪些任务时的选择效应)。
测量生产力的其他手段
AI 工具对开发者生产力的影响,是 AI 研发加速的重要输入。我们计划继续探索以下研究路线:
- 更高强度的实验。 如果依从率更高,选择问题会得到缓解——可以通过运行更短、更密集的实验并可能提高报酬来实现。
- 观察性数据。 关于 AI 在软件开发中使用情况的丰富数据源很多——从聚合统计(例如约 4% 的 GitHub commit 由 Claude Code 署名)到细粒度转录(如 Sarkar (2025))。我们打算继续观察我们的开源开发者池,理解 AI 是如何被使用的。
- 问卷调查。 尽管自报的生产力反事实难以解读、可能有偏,我们仍乐观地认为,精心设计的问卷问题配合时间使用研究,能产生有用的信号。
- 固定任务实验。 我们的原始研究的新颖之处是让开发者先自选任务、再做随机化。我们可以退回更简单的设计:给开发者固定的任务,随机分配是否允许 AI 辅助。
- 能力评测。 METR 会继续构建任务评测,衡量智能体自主完成任务的能力——这与智能体采纳的生产力效应有明确的关联。
- 开发者级实验。 另一种设计是在开发者层面而非任务层面做随机化,即每位参与者要么所有任务都用 AI、要么都不用。这缓解了任务级的选择问题,但加重了开发者级的选择问题,并且检测生产力效应的统计功效更低。
随着模型能力持续提升,我们预计需要不断重新设计我们的一部分能力与测量技术。
生产力研究的细节
我们付给开发者每小时 50 美元,让他们在自己现有的开源项目上工作,并把 issue 随机分为允许 AI 或禁止 AI。开发者都是经验丰富的开源贡献者,从业年限中位数 10 年。我们的数据覆盖 57 名开发者、143 个仓库、800+ 个任务。
其中 10 名开发者来自原研究,其余为新招募,来自更多样化的仓库集合——包括更小、更绿地(greenfield)、成熟度更低的仓库。
早期研究的完整数据集与最近这次研究的数据集均已公开。
译注(本仓库视角): 这篇是 YDD 效率悖论文章所引用的 METR RCT("AI 辅助反而慢 19%")的官方后续。三点值得注意:
- "慢 19%" 从此只能作为 early-2025 的历史快照引用,不能再当作活事实;
- 新数据的方向转为加速(-18% / -4%),但 METR 自己反复强调这是弱证据——诚实报告测量失效本身,比给出一个新数字更有价值;
- 最有信息量的发现或许是元层面的:AI 渗透已经破坏了任务级 RCT 这种测量手段本身(拒绝参与、回避提交高增益任务、并发智能体使计时失效)——"测量方法追不上被测对象",与编码基准侧的诊断(Position 论文)同构。