
面向编码智能体的可维护性传感器
译注: 本篇为节译,译至原文 "Static code analysis: AI modularity review" 一节为止;其后的变异测试传感器、sidecar 工具附录与传感器简史(含原文 Figure 5–11)未译,请参见原文。frontmatter 的
sourceFigureCount: 4对应已译部分的图数。
我们通常希望在代码库中达成并监控多个维度:功能正确性(按预期工作)、架构适应度(足够快、安全、可用),以及可维护性。我在这里把可维护性定义为:让代码库随着时间推移仍然容易修改,而且修改风险较低,也就是所谓"内部质量"。所以,我不只是希望今天能快速改动,也希望未来仍然能快速改动。我也不希望每次自己修改,或者让 AI 修改时,都担心引入 bug 或让适应度下降。对 AI 生成的代码库来说,我通常看到的第一批可维护性裂缝,是为一个小调整而改动的文件数量开始增加;或者是改动开始破坏过去能工作的东西。
内部质量问题影响 AI智能体的方式,和影响人类开发者很相似。一个智能体如果在纠缠不清的代码库里工作,可能会在错误的地方寻找已有实现,因为没有发现重复而制造不一致,或者被迫加载比任务本身所需更多的上下文。
在这篇文章中,我会描述自己对各种传感器的实验:这些传感器帮助我们和 AI 反思代码库的可维护性,以及我从中学到了什么。
应用程序
我正在做一个面向社区经理的内部分析仪表盘。它会从多个 API 读取聊天空间活动、参与度和人口统计数据,并把这些数据呈现在 Web 前端中。
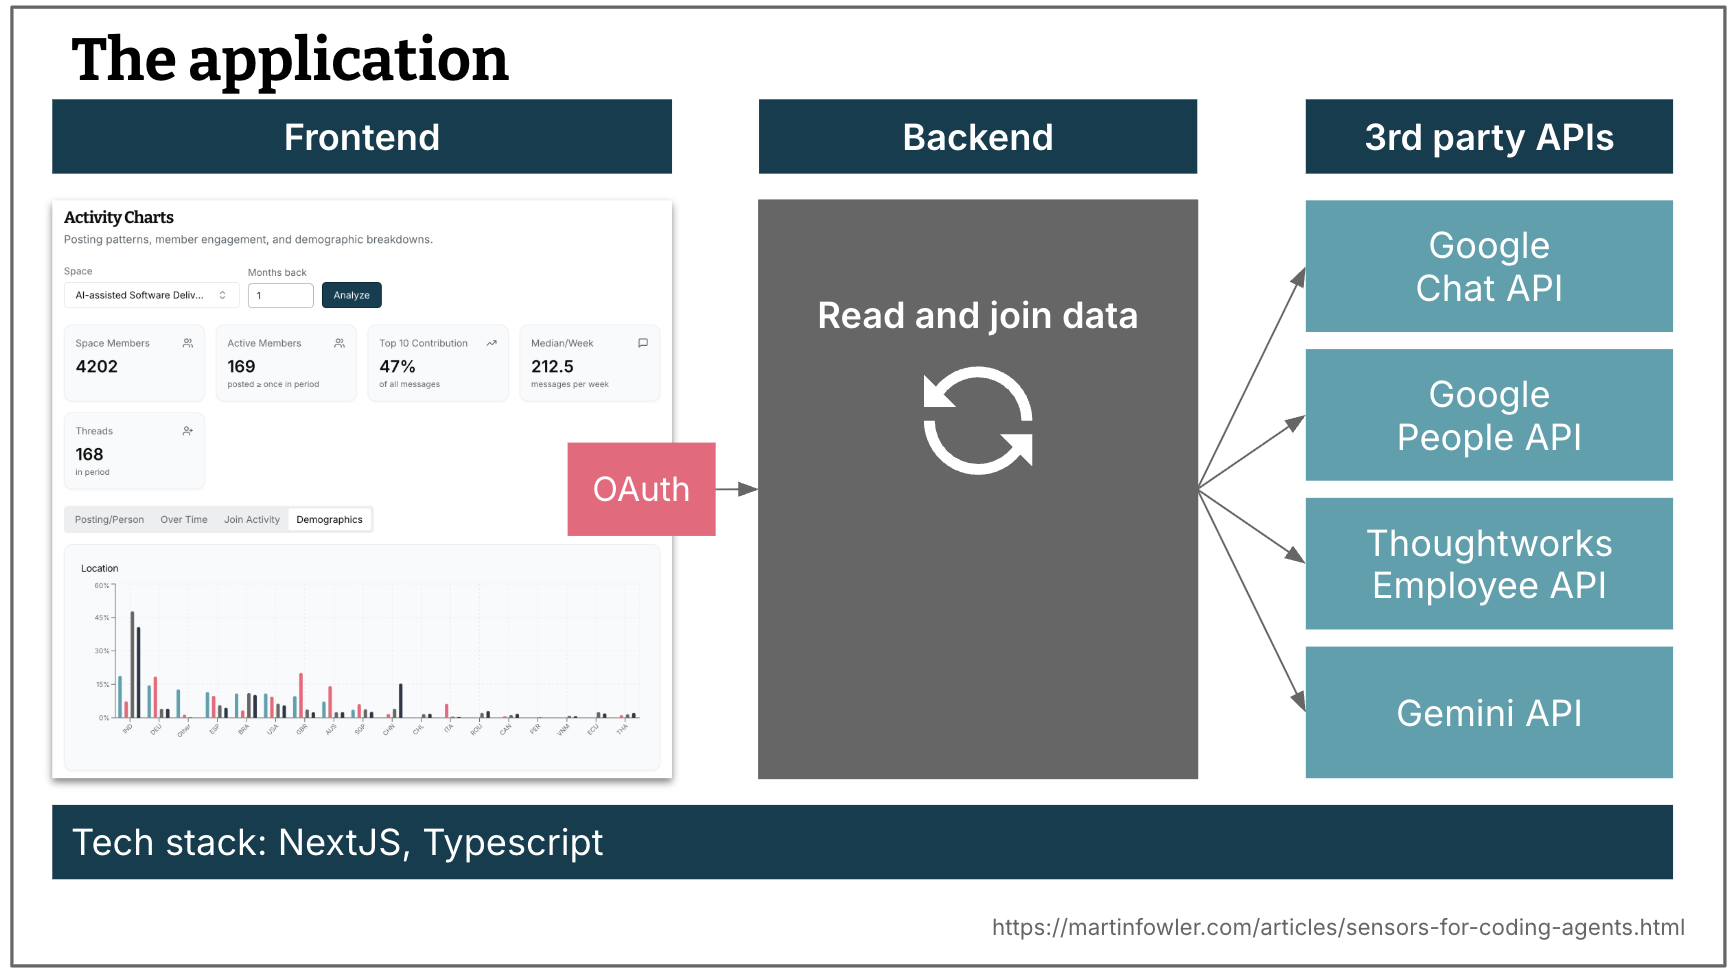
图 1:示例应用:Web UI、服务层和外部 API。
技术栈是 TypeScript、NextJS 和 React。后端从这些 API 读取并关联数据。这个应用已经存在了一段时间,但为了这些实验,我让 AI 从零重建了它。
项目中几乎没有关于代码质量和可维护性的 AI 引导器(例如 markdown 文件)。我想看看,如果只依赖传感器反馈,它能做到多好。
所有传感器概览
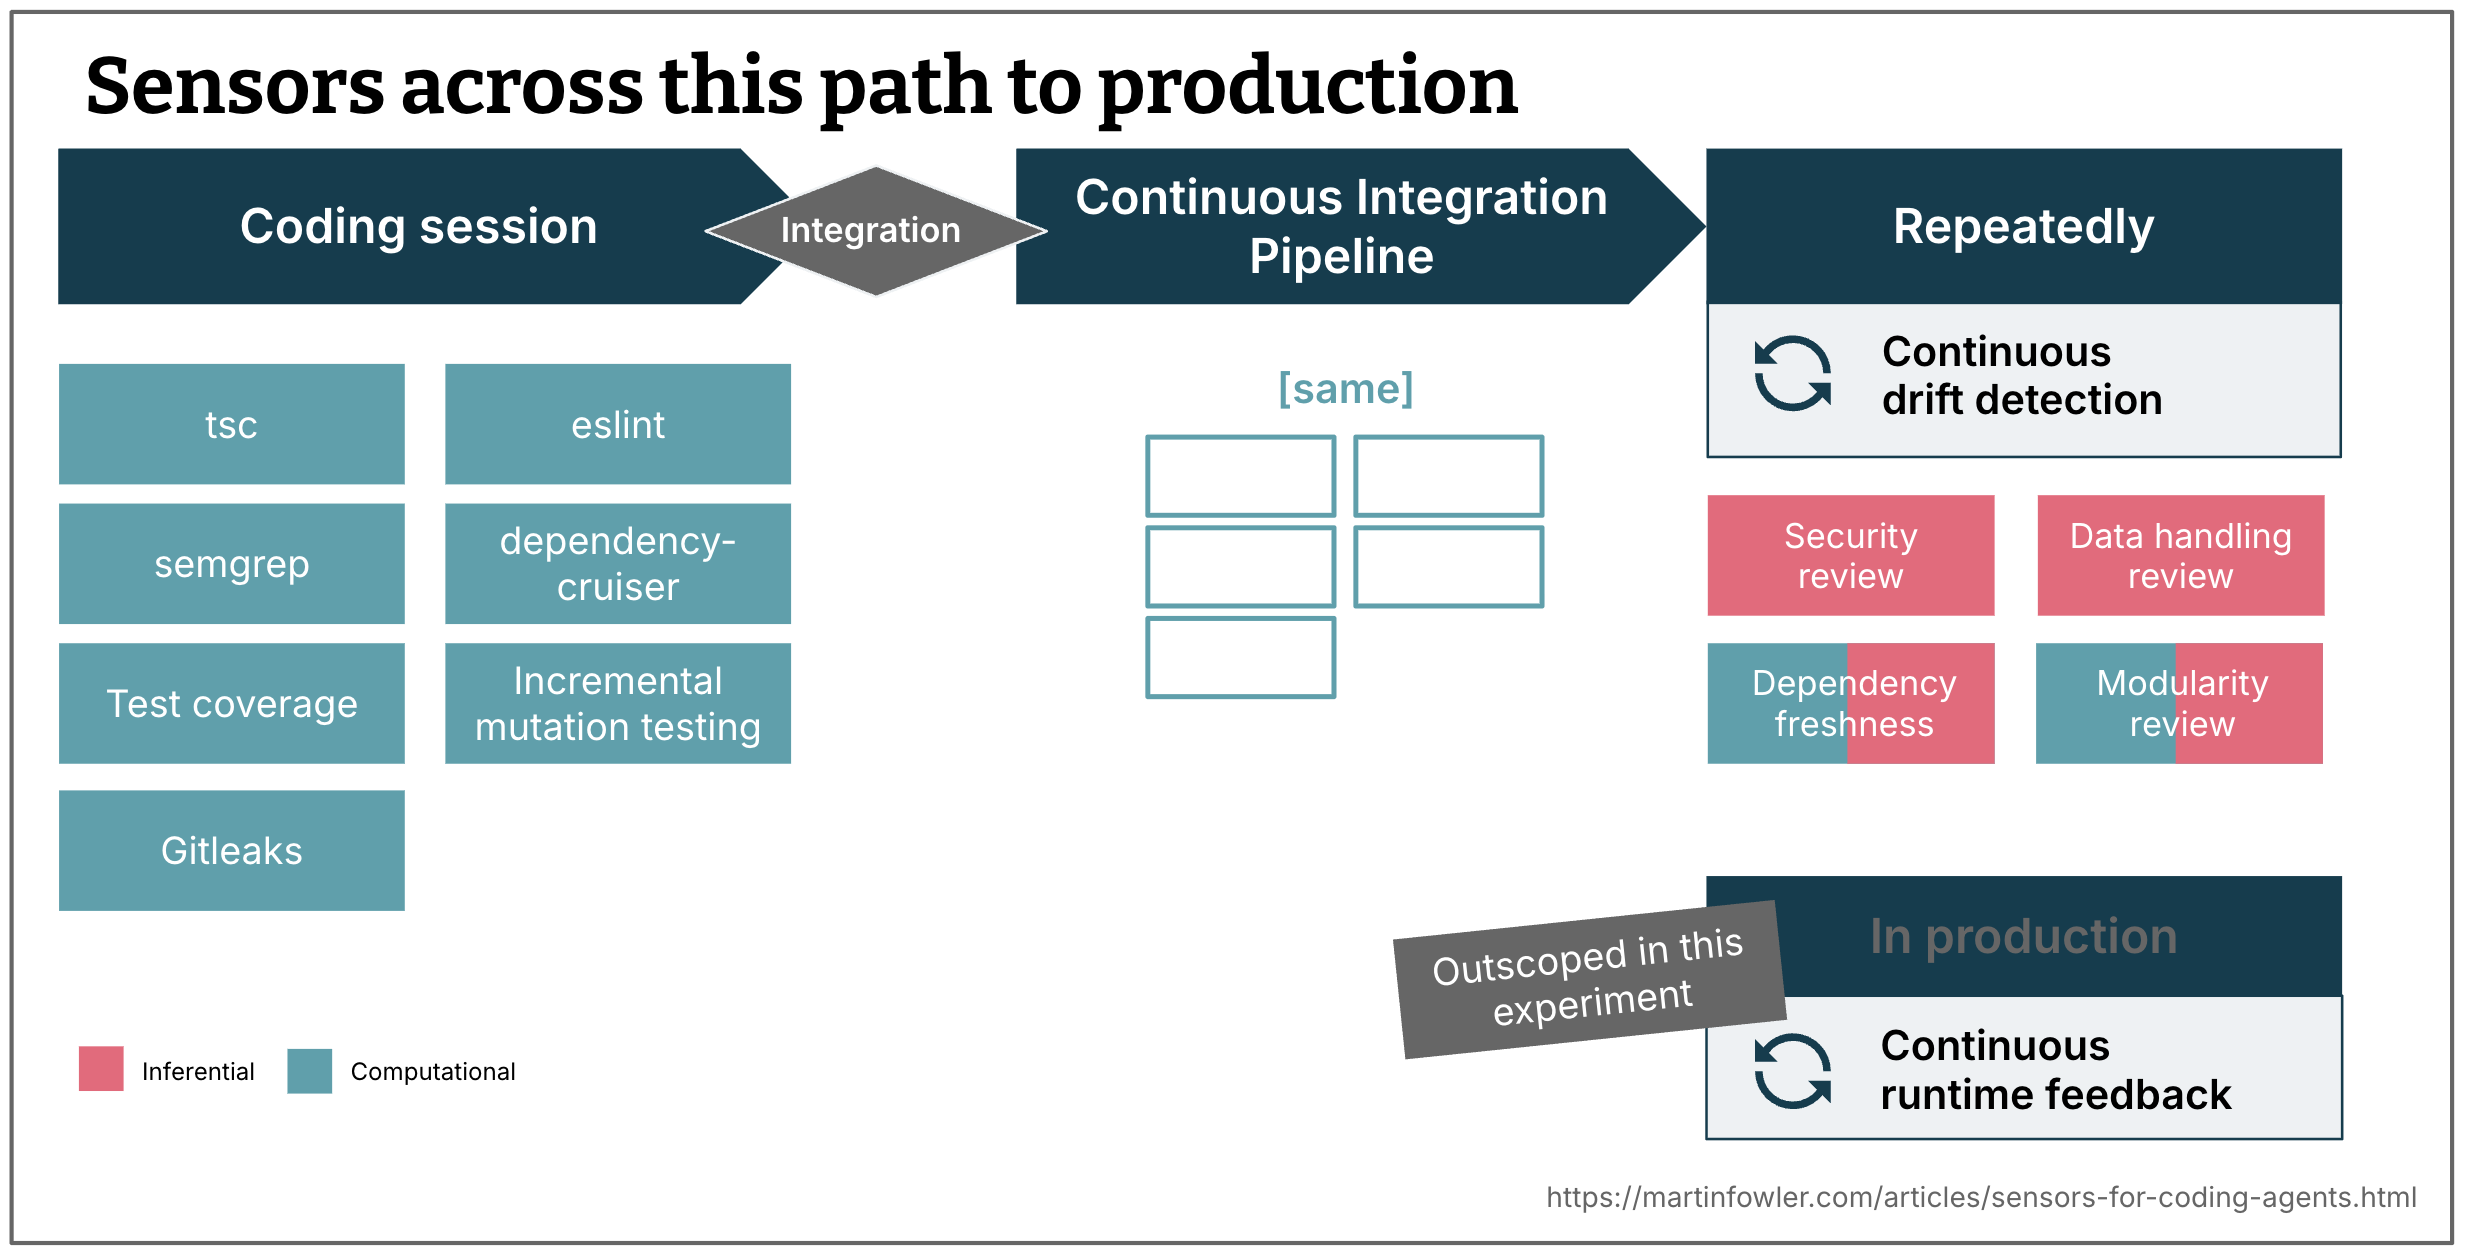
图 2:传感器可以运行的位置:初始编码会话期间、流水线中、按计划运行,以及生产中。
这是我在通往生产的路径上设置的传感器概览。
编码会话期间
这些传感器持续与智能体并行运行,提供快速反馈。
- 类型检查器(计算性)
- ESLint(计算性)
- Semgrep,我们内部 AppSec 团队指定的 SAST 工具(计算性)
- dependency-cruiser,运行结构规则来检查内部模块依赖(计算性)
- 测试套件结果,包括测试覆盖率(计算性;不过测试套件由 AI 生成,因此其创建过程是推理性的)
- 增量变异测试(计算性)
- GitLeaks 作为 pre-commit hook 的一部分运行。我也把它视为一个传感器,因为当智能体尝试提交时,它会给智能体反馈(计算性)
集成之后:流水线
同样的计算性传感器会在 CI 中再次运行。会话内传感器在开发期间给智能体提供早期反馈;CI 流水线则在干净的基础设施上、集成之后确认结果。
重复运行
这些传感器以较慢的节奏运行,用来检测随时间累积的漂移,而不是当下发生的错误。
- 安全评审,提示词来自我们内部应用的 AppSec checklist(推理性)
- 数据处理评审,提示词描述诸如"用户姓名绝不能被发送到 Web 前端"之类的规则(推理性)
- 依赖新鲜度报告。它先运行脚本获取库依赖的年龄和活跃度,再让 AI 生成报告,给出潜在升级、弃用等建议(计算性和推理性)
- 模块化与耦合评审(计算性和推理性)
交代完这个背景之后,让我们深入第一类传感器。
基础 Harness 和模型
在构建这个应用的过程中,我混合使用了 Cursor、Claude Code 和 OpenCode(按使用频率从高到低)。我的默认模型通常是 Claude Sonnet;一些规划和分析任务使用 Claude Opus;实现任务则经常使用 Cursor 的 composer-2 模型。
静态代码分析:基础 linting
我先从这个应用中使用 ESLint 的经验讲起。ESLint 这样的基础 linting 工具,主要在单个文件和函数层面针对可维护性风险。
针对典型 AI 短板的规则
根据我的经验,最适合用静态代码分析捕获的 AI 失败模式,也就是最容易摘到的果子,包括:
- 函数参数数量上限
- 文件长度
- 函数长度
- 圈复杂度
不过,这些规则甚至没有在 ESLint 的默认预设里启用,我必须先为它们配置最大值。希望静态分析工具会逐步演进,提供更适合 AI 使用场景的预设。我稍微研究了一下,发现人们已经开始发布专门针对已知智能体失败模式的 ESLint 插件规则集,比如 Factory 的这个插件,其中包含要求测试文件、结构化日志等规则。
用于自我修正的指导
传感器的目的,是给智能体反馈,让它可以自我修正。理想情况下,我们还希望给智能体一些额外上下文来帮助这种自我修正,也就是一种好的提示词注入(prompt injection)。为此,我在 AI 的帮助下构建了一个自定义 ESLint formatter,用来覆盖部分默认消息。
下面是我为 no-explicit-any 警告写的指导示例。
我们希望类型足够明确,以便更容易避免错误,尤其是关键概念。
但我们也希望避免用不必要的类型把代码库弄得很杂。请做出判断。
如果你选择不引入类型,请用下面这种方式抑制它:
// eslint-disable-next-line @typescript-eslint/no-explicit-any -- (说明原因)
管理警告:现在更可行了吗?
静态代码分析已经存在很久了,但团队常常没有持续使用它,即使已经把它配置好了。原因之一是它带来的管理开销。有效使用这类分析,需要团队保持"屋子干净",否则指标就会变成噪音。尤其是像上面 no-explicit-any 这样的警告 很棘手,因为你并不总是想修复它,具体要看情况。而逐条抑制这些警告 过去总让人觉得繁琐,也像是在代码里制造噪音。
有了编码智能体,我们现在也许有机会保持干净基线。在上面的指导文本中,智能体被要求做出判断,并被允许在代码中抑制警告。这样可以让抑制保持可管理、可见、可审查。
对于最大行数、最大允许圈复杂度这类阈值,我在 lint 消息里告诉智能体:如果它认为某个具体场景下重构没有必要或不可能,可以略微提高阈值。这并不是永久抑制阈值,只是提高它,因此如果未来情况变得更糟,规则仍会再次触发。约束被保留下来,同时避免了"要么抑制,要么完全遵守"的二元选择。
观察
- 查看 AI 创建的例外(被抑制的警告、被提高的阈值),是我开始代码审查的一个好切入点。
- AI 经常决定提高圈复杂度阈值,但当我进一步推动时,它会提出不错的重构方案。这是它唯一会这么做的类别。后来我发现,我并没有为这一项设置自我修正指导,所以没有显式说明"提高阈值应该是绝对例外"。这表明自定义 lint 消息确实能带来相当大的差异。
- 有时,我希望在代码的不同部分以不同方式对待规则。以
no-console为例,它会在 AI 使用console.log时提醒它。在后端,我希望它改用 logger 组件。在前端,我可能根本不想直接 logging,或者至少需要使用另一个 logging 组件。这是自我修正指导发挥作用的另一个例子,也体现了 AI 可以帮助进行语义判断和分析警告管理的地方。 - 我一直在留意规则之间取舍的例子。目前我见过的唯一一个,是由
max-lines和max-lines-per-function规则造成的。我看到 AI 因为这些传感器反馈而做了不少有用的重构,把代码拆成更小的函数和组件。然而,在 React 前端,我看到一个令人担忧的趋势:组件拥有越来越多的属性,这是因为值被沿着一条越来越长、组件越来越小的链路传递。我还没有得到足够有用的观察,来判断 AI 在这类取舍之间做出一致决策的能力到底如何。
主要收获
总体来说,静态分析能覆盖的东西之多让我很惊喜。我好几次提醒自己:为什么过去它有些使用不足?现在又发生了什么变化?答案是成本收益平衡。成本降低了,因为有了 AI,创建自定义脚本和规则便宜得多。收益也提高了:分析结果能帮助我先了解很多卫生因素,而这些问题在我自己写代码时本来并不会那么常见,所以我可以先清掉常见的 AI 错误。
不过,我还是忍不住怀疑,这是否也会带来一种虚假的安全感和质量幻觉。毕竟,过去我们较少使用这类 linter 的另一个原因,是它们有局限,而我们一直警惕把它们当成质量的简化指标。静态分析无法捕获许多更语义化的质量方面,AI 是否能与这些工具协作来充分填补这个缺口,还有待观察。我还发现,每次启用一组新规则,代码里都会冒出一些所谓的新问题。其中总是混杂着无关紧要的东西和真正重要的东西。因此,我担心传感器反馈过载,把智能体推入过度工程化重构的螺旋。
静态代码分析:依赖规则
基础 linting 主要关注文件或函数内部的质量和复杂度。接下来,我开始研究那些能给我和智能体提供跨文件、跨模块边界可维护性反馈的传感器。历史上,这个领域的分析工具比基础 linting 还更少被充分使用。
为了了解传感器如何帮助我们和 AI 在代码库内部保持良好模块化,我探索了三件事:
- 依赖规则(确定性)
- 耦合分析(确定性和推理性)
- 模块化评审(推理性)
先从依赖规则开始。在应用实现到一半左右时,我和智能体一起为应用设计了分层模块结构。我请它帮我编写 dependency-cruiser 规则来强制这些层次。
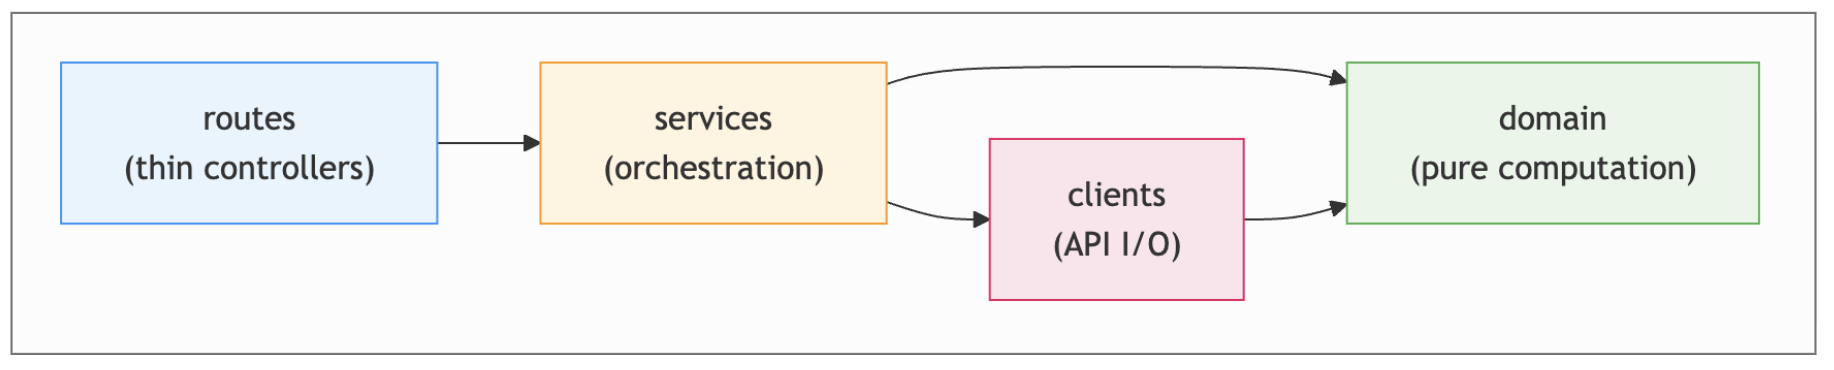
图 3:分层模块结构和依赖规则
例如,其中一条规则强制 clients 文件夹中的代码绝不导入 services 文件夹中的任何东西:
{
  name: “clients-no-services”,
  comment:
    “API clients must not depend on the orchestration layer above them. “ + LAYERS,
  severity: “error”,
  from: { path: “^server/clients/”, pathNot: “/__tests__/” },
  to: { path: “^server/services/” },
},
和 ESLint 消息一样,我也稍微扩展了错误消息,让它成为自我修正指导,并概括整个分层概念:
ERROR  clients-no-services
  API client 不能依赖它们之上的编排层。
  [层次:routes -> services -> clients + domain;Services 负责编排:
  通过 clients 获取数据,通过 domain 计算;不做 I/O,不使用 SDK,不了解数据获取细节。]
观察
- 如果没有 AI,我不可能这么快把这些规则放到位。这个工具的配置语法有很陡的入门成本,而 AI 几乎完全吸收了这部分成本。
- 引入规则后,智能体违反过几次规则,随后会根据
dependency-cruiser反馈自我修正,所以它确实有助于维持我的文件夹概念。 - 我也用同样的方法为前端 React hook 的结构引入约定。
- 我必须想办法捕获 AI 开始在这个结构之外创建新文件的情况,于是增加了一条规则,要求每个新文件都必须位于预定义文件夹结构中的某个位置。
主要收获
在我引入这些规则时,代码的文件夹结构已经变得有点随意。我能看到这些规则帮助智能体清理结构,并继续向前强制这些层次。因此,我觉得它相当适合替代 markdown 引导文档 中对代码结构的描述。不过,这类工具受限于 import、文件名和文件夹结构所能表达的东西。
静态代码分析:耦合数据
接下来,我实验了从代码库中提取典型耦合指标,也就是每个文件的传入和传出 import 与调用数量。
我没有使用现有工具,而是让一个编码智能体借助 TypeScript compiler 写了一个应用来生成这些指标。这样我就能获得最大的灵活性,把它作为实验的一部分来玩。它添加了两个界面:一个 Web 界面,包含多种不同的指标可视化,供我这个人类消费;另一个 CLI,可以把这些指标提供给编码智能体。
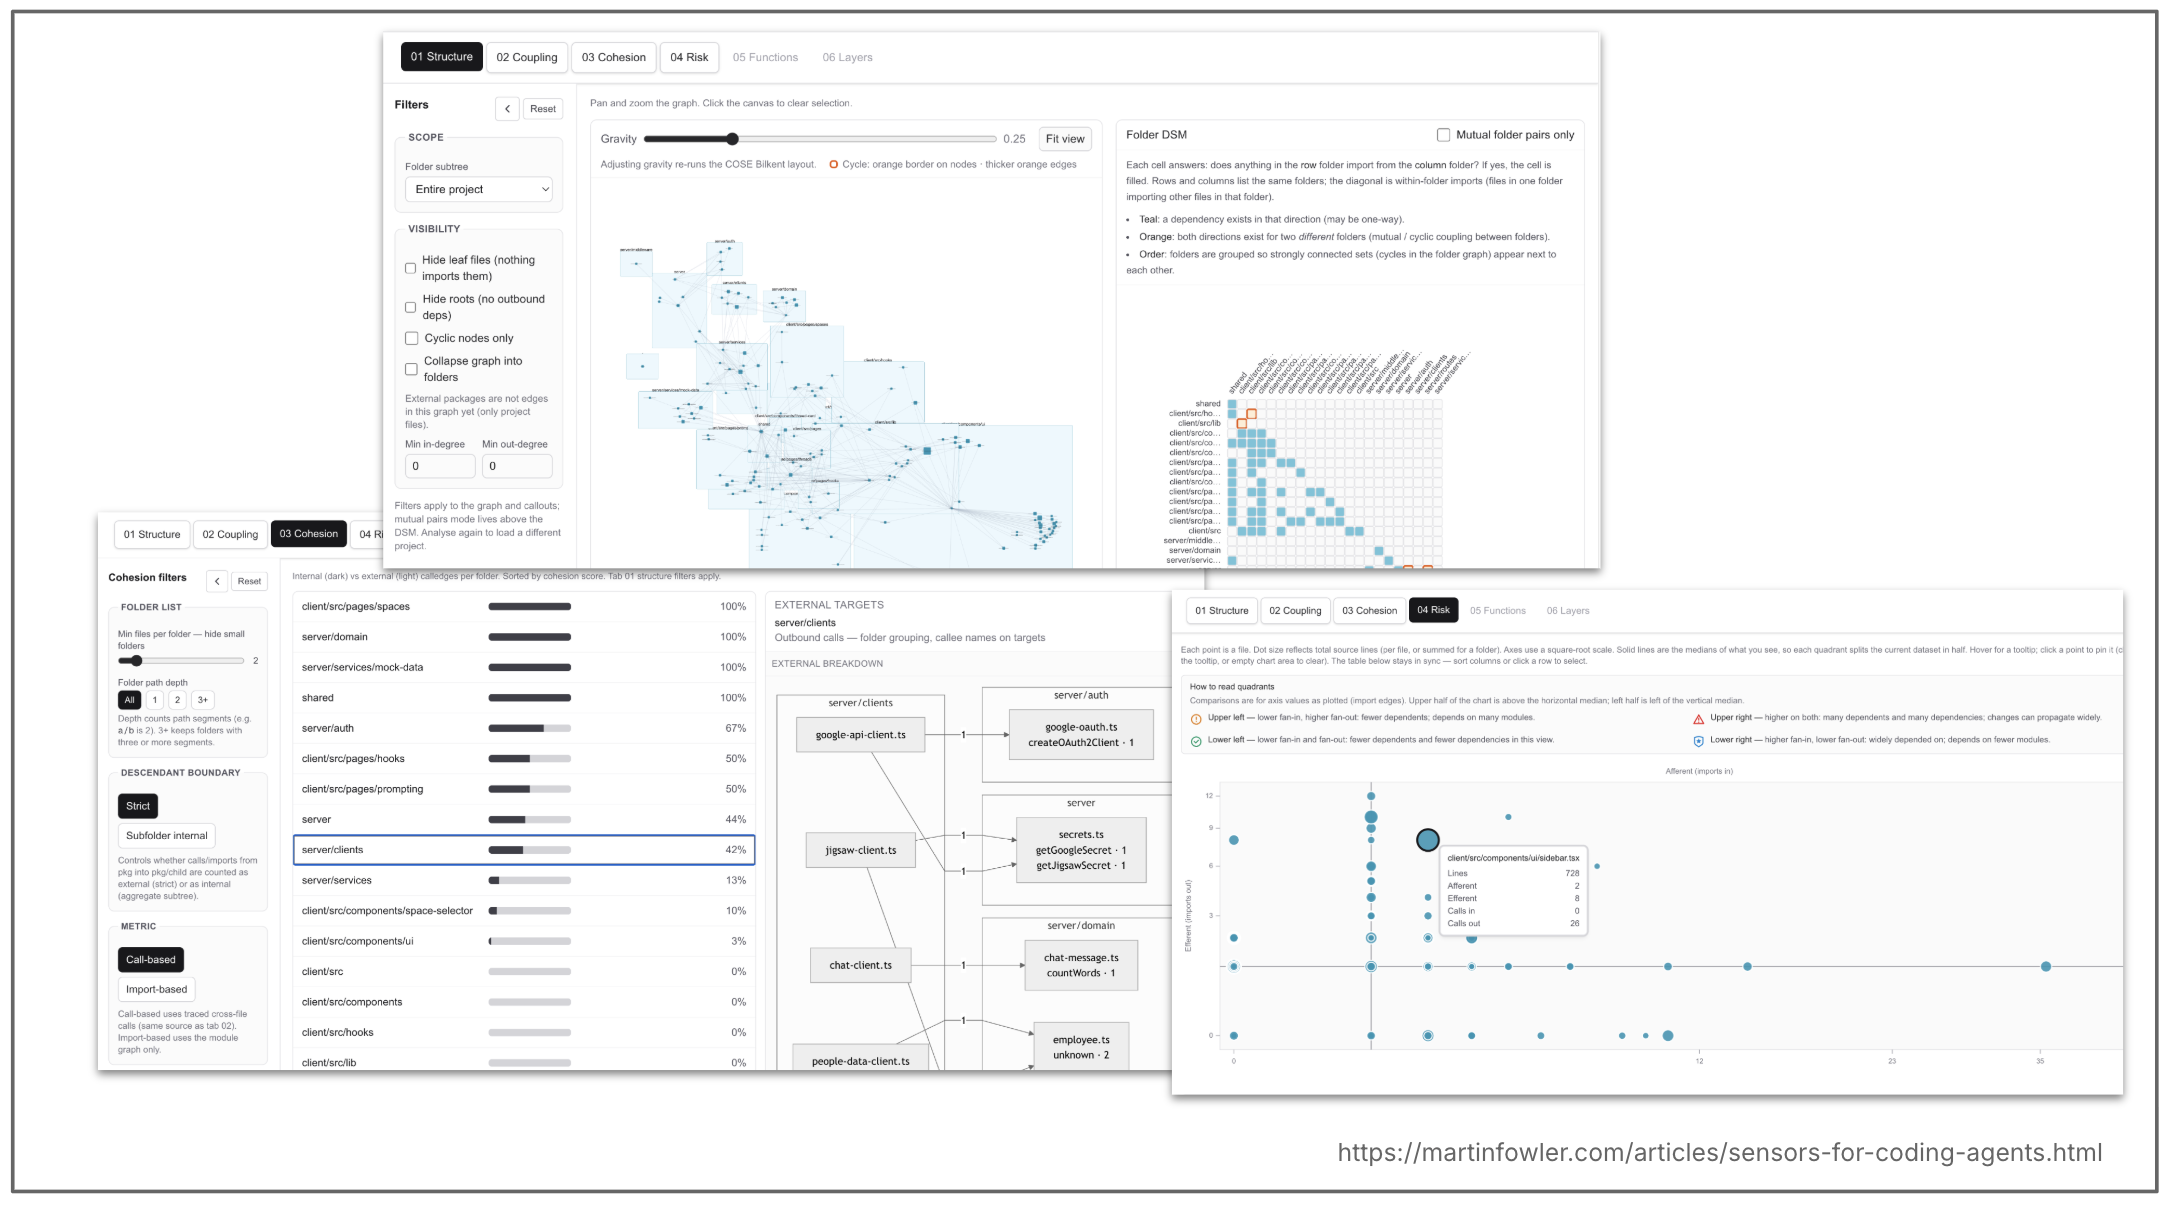
图 4:耦合指标:面向智能体的 Web 可视化和 CLI。
面向人类消费
这些可视化大多是成熟概念,比如依赖结构矩阵(DSM)。我发现它们解释起来很繁琐。尽管它们是 Vibe Coding 做出来的,当然还有很多改进空间,但我认为这更多与数据本身的性质有关。这类数据非常细,需要大量上下文和经验才能解释,并映射回更高层次的良好实践。因此,我感觉当人类审查由 AI 修改过的代码库时,这类工具仍然不会真正显著降低人的认知负担。
面向 AI 消费
我让智能体访问这个自定义 CLI(coupling-analyser),并要求它基于数据创建一份报告,包括如何改善关键问题的建议。
下面是那段提示词的摘录。我主要把它放在这里,是为了说明我并没有给它太多关于模块化好坏的指导;我基本上把解释什么是好、什么是坏这件事委托给了模型:
基于 npx coupling-analyser 的实际 CLI 输出,而不是仅凭静态浏览猜测,为目标 TypeScript 代码库生成一份关于模块化与耦合质量的 markdown 报告。
收集证据(运行 CLI)
执行 CLI 并捕获 stdout。使用 report 子命令;根据问题需要组合使用:……
编写 markdown 报告
使用清晰标题。优先引用或转述 CLI 输出中的具体模块 ID / 路径和数字。
建议章节:
- 上下文:分析了什么
- 执行摘要:2-5 个要点:整体模块化状态、前 1-3 个系统性问题。
- 工具发现:总结 CLI 报告中的热点、最高风险、值得注意的循环或相互依赖,以及行为亮点。
- 解释(模块化视角):把指标与软件设计联系起来:内聚 vs. 变更扩散,稳定性 vs. 依赖方向,fan-in/fan-out 直觉,循环的影响。
- 每个 high 和 critical 问题的深入分析
- 它是什么:模块、在系统中的角色、依赖邻居(来自 CLI + 必要时少量代码查看)。
- 当前职责……
- 为什么有害……
- 设计选项(合理时给出 2 个以上)……
- 为什么新设计更好:更少循环、更清晰的依赖方向、更小的表面、更好的测试缝隙、与可能的变化方向一致。
- 未来变更风险:每个选项如何降低回归风险,让安全演进更便宜(具体场景:"添加 X"、"替换 Y"、"独立发布 Z")。
……
这次由 LLM 主导的分析,确实指出了与我查看可视化图表时会发现的相同耦合热点,但格式更易消化。要求 LLM 把分析建立在确定性工具结果之上,让我有了更高的信心,而且可能也比让智能体自己扫描代码库寻找耦合问题更省时间和 token。
观察
这个 LLM 基于这些数据找到的东西相当乏善可陈(我这次用的是 Claude Opus 4.7):
- 它说最大的问题之一,是一个初始化所有必要组件的 factory;但我有意引入这个 factory,让它作为一个轻量级依赖注入框架。
- 它提出的另一个问题,是前后端共享的 (
zod) schema,被 LLM 宣称为一个 "god module"。但这是创建前后端显式契约的常见模式,而且在前后端本来就一起演进,甚至像我这里一样放在同一个仓库里时,并不是什么大问题。 - 当合理模式表现为高耦合 hub 时,未来的分析中必须有办法抑制这些情况,否则它们会制造更多噪音。
- 它提出的一个有点意思的发现是:domain 文件夹中的一个
index.ts文件不加区分地暴露了./domain中的所有文件,并被很多地方导入。虽然这也是为某一层创建显式契约的常见模式,但它确实有利有弊,至少值得调查一下它是否适合这个代码库。
主要收获
上面的例子显示,比基础 linting 更明显的是,好和坏并没有清晰定义,关键在于什么是合适。而什么样的耦合是合适的,取决于大量上下文,不只是代码库的原始调用图和 import 图。因此,基于这个小实验,我并不觉得这类耦合数据本身对 AI 有多大用处。
我能想象到的一个更实际用途,是在代码审查的风险分诊中使用这些数据。当我审查 AI 做出的代码变更时,如果知道被修改文件的影响半径,会很有用。比如一个有 10 多个调用方的文件被修改了,我就可以多花点注意力。或者,AI 评审智能体可以用这些数据来决定把 token 优先花在哪里。
静态代码分析:AI 模块化评审
耦合数据实验的结果不太亮眼,可能有多个原因:
- 我关于要分析什么的提示词不够具体
- 耦合数据对 AI 没有用
- 只有耦合数据太浅,缺少完整代码上下文
所以我最后做的事情,是完全走推理性路线,使用 Vlad Khononov 的 "Modularity Skills" 来分析代码库设计并寻找模块化问题。事实证明这非常有成果!它给了我许多有趣的重构线索,而这些重构显然会降低未来变更风险。我第二次运行这些 skills 时,让它们访问了我的耦合分析 CLI。AI 基本上在数据中找到了印证,但没有额外发现。相反,它指出了很多 CLI 漏掉的东西。还值得注意的是,第二次分析(没有第一轮上下文)暴露了另一个第一轮没有发现的问题。这是一个有用的提醒:在事情重要时,通常值得多次运行基于 LLM 的分析,以获得更完整的图景。
观察
下面是一些结果亮点(使用的模型同样是 Claude Opus 4.7,与耦合分析相同):
- 重复的 route 代码:我的三个后端 endpoint 各有自己的 route 文件,而每个 route 实现几乎完全相同。所以只要我想对后端 API 的一般原则引入变更(比如引入 request ID,或者改变错误处理或 logging 方法),就必须在多个文件中修改。我才刚刚引入第三个 endpoint,所以这时还没有抽象出来,我觉得还算合理。但根据我的经验,当 AI智能体第三次或第四次重复一段代码时,它们通常不会主动开始重构,除非你明确推动;它们很乐意复制粘贴。
- 调用后端方式不一致:换句话说,这是另一种形式的语义重复。应用中有 3 个页面需要用同一组参数调用后端(选中的聊天空间,以及要分析的日期范围)。其中两个页面使用同一个 hook 和通用方法来做这件事,但当 AI 引入第三个页面时,它偏离了这个方式,并以自己的方式重新实现了类似行为。这可能导致错误处理不一致,或者当后端 API 原则变化时,又需要修改多个文件。
- 核心参数处理低效:如前所述,应用中所有页面都会把聊天空间 ID 和日期范围传给后端。当我改变用户指定日期范围的方式时,我已经注意到 AI 需要修改很多文件,超过 40 个!所以我已经意识到这里不太对劲,而分析确认了这一点:"问题:请求参数在每一层重复"。建议是引入一个对象来包装所有这些参数。AI 其实已经以某种方式做了这件事,但从未完全贯彻这个对象的使用,于是变成了一团不一致的混乱。
- 职责放在了错误的位置:评审发现有一小段认证代码放在了我们的 factory 里面,而这个 factory 本应只负责把模块连接起来。它在用户未认证时实现了 fallback 到 mock data。像这样出现在意外位置的代码,会在添加新 route 时带来被遗漏的风险。
- 更好地解释可接受的高 import 计数 "hub":还记得我之前的耦合分析找到的那些 "god classes" 吗?模块化 skills 也注意到了它们,但在两个案例中都很好地指出:在这个应用的上下文中,它们有自己的目的。我猜这要么归功于这些 skills 中好的提示词,要么归功于这次分析实际读取了代码内容,而我要求另一个分析只依赖耦合数据。
主要收获
- 像
dependency-cruiser这样的依赖解析器,可以成为有效的实时传感器,用来强制一些基础文件夹结构和依赖方向,但它们的能力有限。 - AI 模块化评审是一个很好的"垃圾回收"例子;在配合强提示词时效果相当不错。把它建立在实际耦合数据之上似乎并没有带来太大差异。如果能找到办法把它应用到一次 commit 中变更的文件上,让它更早进入流水线,那会很好,但我还没有探索这一点。
- 我是在几乎构建完大部分代码库之后,才运行模块化评审的,之前没有自己应用这种评审。它发现了一些相当令人担忧且非常有效的问题,这些问题会增加未来风险。这表明,如果没有人类评审和耦合专业知识,也没有这些额外 AI 评审,智能体确实会持续累积无意中的技术债。
总体而言,代码库设计和模块化似乎是这样一种关注点:单靠计算性传感器帮不上太多;我们需要 AI 加入语义解释,并考虑取舍。